Passare un comportamento come argomento
Finora abbiamo passato a un metodo numeri, stringhe e oggetti. Talvolta vogliamo passargli anche una scelta: come trasformare un testo, quando accettarlo, che cosa fare con il risultato. In Java questa scelta può essere rappresentata da un oggetto che implementa un'interfaccia con un solo metodo astratto. Una lambda è una forma concisa per fornire proprio quell'implementazione. Non trasforma Java in un linguaggio funzionale puro, ma rende più semplice trattare un comportamento come valore utilizzabile da altre operazioni.
Partiamo da un problema familiare: un metodo deve svolgere un lavoro stabile, ma il chiamante vuole cambiare una decisione. Vedremo come dichiarare il comportamento richiesto, come passarlo e come controllare il risultato. Solo quando un esempio lo richiederà daremo un nome ai principi più avanzati. Così una definizione non resta sospesa senza un programma a cui applicarla.
Definizione – Interfaccia funzionale. È un'interfaccia con un solo metodo astratto da implementare, per questo chiamata anche SAM, da Single Abstract Method. Può avere metodi default o statici senza perdere questa proprietà.
@FunctionalInterfacechiede al compilatore di controllarla. La lambda riceve il tipo bersaglio dal contesto: non è un pezzo di codice privo di tipo che si possa assegnare a qualunque variabile.
Perché introdurre le funzioni in un linguaggio a oggetti
Immaginiamo di avere un metodo che confronta due prezzi. Il metodo sa ottenere i prezzi, ma non sa se il chiamante vuole calcolare la differenza, la somma o il maggiore. Una prima soluzione consiste nel passargli un codice numerico, per esempio 1 per la somma e 2 per la differenza. Il metodo contiene allora un switch che cresce ogni volta che appare una nuova operazione. Il numero 2, letto dopo sei mesi, non spiega nulla. Una seconda soluzione consiste nel duplicare il metodo per ogni scelta: anche questa strada cresce male, perché tutta la parte che ottiene e valida i prezzi viene ripetuta. La necessità concreta è passare al metodo il comportamento che cambia, lasciando in un solo posto il lavoro comune.
Questo problema non nasce con Java 8. Le interfacce e il polimorfismo del capitolo 13 lo risolvevano già: dichiariamo un contratto con esegui(int, int) e passiamo un oggetto che lo implementa. Le lambda abbreviano la scrittura dell'implementazione quando il contratto ha un solo metodo astratto. Il beneficio non è il numero di parentesi risparmiate, ma la possibilità di vedere vicino alla chiamata quale decisione stiamo affidando al metodo. Se la decisione è complessa, continua ad avere senso darle un nome in una classe o in un metodo ordinario.
Nel programma completo DemoPercorsoLambda.java, calcola riceve tre argomenti: i due numeri e un'Operazione. Il metodo non conosce la sottrazione né la somma; chiama operazione.esegui(a, b). La prima operazione è una classe anonima, la seconda una lambda, la terza un riferimento al metodo statico somma. Le prime due stampano entrambe 7, la terza 13. Quel risultato uguale per due forme diverse è la verifica che abbiamo cambiato come forniamo il comportamento, senza cambiare il contratto usato da calcola.
@FunctionalInterface
interface Operazione {
    int esegui(int a, int b);
    default String descrizione() {
        return "operazione su due interi";
    }
}

static int calcola(int a, int b, Operazione operazione) {
    return operazione.esegui(a, b);
}
La dichiarazione dell'interfaccia rende espliciti dominio e risultato: riceve due int e produce un int. Il metodo descrizione è default: possiede già un corpo e non aggiunge un nuovo obbligo a chi implementa l'interfaccia. Per questo l'interfaccia resta funzionale. L'annotazione @FunctionalInterface non crea la proprietà; chiede al compilatore di segnalarci se una futura modifica la distrugge. Se qualcuno aggiungesse int annulla(int a, int b); come secondo metodo astratto, il programma smetterebbe di compilare nel punto in cui il contratto è dichiarato, non soltanto nelle chiamate sparse nel progetto.
Dal problema alla soluzione. Quando una famiglia di operazioni cambia ma chi le esegue resta uguale, un'interfaccia funzionale rappresenta la parte variabile. Una lambda è una possibile implementazione di quel contratto. Verifichiamo passando due comportamenti diversi allo stesso metodo e osservando risultati diversi sui medesimi dati; trasferiamo poi la stessa idea a un filtro di nomi, a un ordinamento o a una regola di validazione.
Prima delle lambda: la classe anonima
La classe anonima nasce in un'espressione con new Operazione() { ... }. Non ha un nome dichiarato nel sorgente, ma è un'implementazione concreta dell'interfaccia. Dobbiamo ripetere @Override, la firma completa del metodo e il return. La forma è più lunga perché possiamo dichiarare anche campi e altri metodi nell'oggetto anonimo. Non è soltanto una lambda scritta con più parole: la sua identità e il significato di this sono differenti.
Operazione classeAnonima = new Operazione() {
    @Override
    public int esegui(int a, int b) {
        return a - b;
    }
};
Operazione lambda = (a, b) -> a - b;
Nella riga della lambda, i tipi di a e b sono dedotti dal metodo astratto esegui. Il compilatore conosce il tipo bersaglio grazie alla dichiarazione Operazione lambda. Se tentassimo var lambda = (a, b) -> a - b;, mancherebbe il tipo bersaglio e il compilatore non saprebbe quale interfaccia implementare. var può essere usato per i singoli parametri in una lambda quando il tipo bersaglio è già noto, per esempio (var a, var b) -> a - b, ma non risolve l'assenza del tipo della lambda intera. Questo dettaglio evita una confusione frequente: la deduzione dei parametri dipende dal contratto, non lo inventa.
Una funzione passata a calcola è un valore nel senso pratico che possiamo assegnarla a una variabile, trasmetterla a un metodo e farla restituire da un metodo. Il metodo aggiungi(int incremento) del programma restituisce un'Operazione; la lambda prodotta usa incremento in una chiamata successiva. Il metodo che riceve o restituisce un comportamento è chiamato funzione di ordine superiore. Java mantiene il proprio modello di tipi: il valore è riferito tramite un'interfaccia funzionale. Parlare di “funzioni di prima classe” è utile per descrivere la possibilità di spostare il comportamento, purché non faccia dimenticare il tipo concreto richiesto dal compilatore.
Che cosa rende funzionale un'interfaccia
Il conteggio riguarda i metodi astratti da implementare, non tutte le righe che sembrano metodi. Un metodo default ha già un corpo. Un metodo static appartiene all'interfaccia e non viene implementato dalla lambda. I metodi pubblici di Object dichiarati in un'interfaccia, come equals(Object), non introducono una seconda funzione indipendente. Una gerarchia può ereditare dichiarazioni equivalenti dello stesso metodo astratto; il compilatore ne verifica la compatibilità. Non conviene imparare una formula superficiale come “una sola parola abstract nel file”: il criterio è che esista un solo contratto astratto funzionale effettivo.
Supponiamo di estendere due interfacce, una con void invia(String testo) e l'altra con boolean verifica(String testo). L'interfaccia figlia richiederebbe due comportamenti e non può essere implementata da una sola lambda. Se invece entrambe ereditano la stessa firma void invia(String testo), le dichiarazioni compatibili possono rappresentare un unico metodo funzionale. Conviene lasciare che @FunctionalInterface lo controlli: il compilatore conosce tutte le regole di override, inclusi i tipi di ritorno e le eccezioni, meglio di una conta manuale.
Un numero eccessivo di metodi default può nascondere un’interfaccia diventata troppo ampia. La cautela resta utile, ma un metodo default ben scelto non è un errore: Function.andThen, Predicate.and e Consumer.andThen sono precisamente metodi di composizione che rendono utilizzabile il contratto. La domanda da fare è se quel metodo appartiene al significato della funzione e se mantiene chiaro ciò che la lambda deve fornire. Se due interfacce ereditate definiscono lo stesso metodo default con corpi in conflitto, bisogna risolvere esplicitamente l'ambiguità; l'annotazione funzionale non decide quale corpo scegliere.
La forma di una lambda, letta senza scorciatoie
La freccia -> separa parametri e corpo. () -> "pronto" non riceve argomenti e restituisce una stringa; testo -> testo.length() riceve un parametro; (a, b) -> a + b ne riceve due. Le parentesi intorno a un solo parametro inferito possono essere omesse. Un corpo formato da una sola espressione usa il valore di quell'espressione come risultato quando il contratto richiede un valore. Se il corpo è un blocco fra graffe e il contratto richiede un risultato, occorre un return su ogni percorso che può terminare normalmente.
BinaryOperator<Integer> sommaBreve = (a, b) -> a + b;
BinaryOperator<Integer> sommaEstesa = (a, b) -> {
    int risultato = a + b;
    return risultato;
};
La seconda forma non è sbagliata: può essere necessaria per controlli o passaggi che meritano di restare visibili. Se la lambda cresce fino a contenere una logica di dominio complessa, estrarre un metodo con un nome chiaro aiuta sia il lettore sia il debugger. Viceversa, togliere le graffe non è possibile se restano più istruzioni. Una lambda destinata a Consumer<String> può chiamare System.out.println(testo) senza restituire un valore, perché il metodo astratto accept ha ritorno void. La stessa espressione non può essere assegnata senza verifica a Function<String, String>, che promette una stringa come risultato.
L’espressione x++ merita attenzione: come espressione restituisce il valore precedente di x, mentre ++x restituisce quello successivo. In una lambda UnaryOperator<Integer> incremento = x -> x++;, il parametro x è una variabile locale della chiamata, perciò la riassegnazione non modifica l'oggetto Integer del chiamante; il valore restituito è addirittura quello iniziale. Per comunicare l'intenzione di incrementare, x -> x + 1 è più corretto e più leggibile. L'analisi della sintassi deve arrivare fino al comportamento osservabile, altrimenti una riga “compatta” insegna la regola sbagliata.
Una lambda può lanciare eccezioni compatibili con la dichiarazione del metodo astratto. Function.apply non dichiara eccezioni checked, quindi una lambda assegnata a Function non può propagare direttamente, per esempio, una IOException senza gestirla. Un'interfaccia propria con throws IOException rende invece quel contratto esplicito. Non bisogna trasformare ogni eccezione checked in una RuntimeException solo per entrare in uno stream: prima si decide dove l'errore deve essere trattato e se la pipeline è davvero la forma adatta al problema.
Il catalogo di java.util.function, a partire dalla domanda
Quando cerchiamo un'interfaccia funzionale, chiediamoci prima che cosa entra e che cosa esce. Supplier<T> non riceve input e fornisce un T tramite get: può rappresentare una fabbrica di valori o il rinvio di un calcolo. Consumer<T> riceve un T ed esegue un'azione con accept, senza promettere un risultato. Predicate<T> riceve un T e risponde true o false tramite test. Function<T, R> riceve un T e restituisce un R tramite apply. Quattro forme rispondono già a molte necessità quotidiane. Nel programma di esempio Supplier<String> etichetta = () -> "Java" produce il testo, mentre Predicate<String> lungo decide se ha almeno quattro caratteri: la stampa true verifica che risultato e condizione non sono la stessa specie di comportamento.
Box – Dominio e codominio. In matematica una funzione associa a ciascun elemento del dominio un risultato nel codominio. In
Function<String, Integer>,Stringindica il tipo degli ingressi eIntegerquello delle uscite. La firma Java non esprime da sola tutte le precondizioni: una funzione che chiamaInteger.parseIntaccetta formalmenteString, ma alcune stringhe causano un errore. Il contratto didattico deve quindi spiegare anche il sottoinsieme di input validi e la gestione dei casi non validi.
Quando ci sono due ingressi, le famiglie BiFunction<T, U, R>, BiConsumer<T, U> e BiPredicate<T, U> esplicitano il secondo tipo. BinaryOperator<T> è un caso di BiFunction nel quale i due ingressi e il risultato hanno lo stesso tipo. UnaryOperator<T> è il caso di Function<T, T>. Nel nostro programma BinaryOperator<Integer> operatore = Integer::sum produce 13 passando 10 e 3. Se i numeri devono restare primitivi e l'operazione è davvero numerica, IntBinaryOperator evita la conversione implicita fra int e Integer: il suo metodo si chiama applyAsInt. La scelta fra due tipi non si riduce alla lunghezza della dichiarazione; parte dalla semantica e, quando serve, dai costi misurati.
BiFunction<Integer, Integer, String> potrebbe prendere due interi e restituire una frase; BinaryOperator<Integer> non potrebbe, perché il risultato deve restare Integer. Queste differenze di tipo aiutano il compilatore a segnalare un'associazione problema-soluzione sbagliata. Se proviamo a usare un Consumer per calcolare un valore, non c'è un risultato da assegnare. Se proviamo a usare un Supplier per una validazione che dipende da un parametro, manca l'input. È più facile ricordare le interfacce partendo da questi vincoli che da un catalogo alfabetico di nomi.
Le varianti primitive coprono combinazioni frequenti: IntSupplier restituisce un int; IntConsumer lo riceve; IntPredicate lo valuta; IntFunction<R> riceve un int e restituisce un oggetto; ToIntFunction<T> riceve un oggetto e restituisce un int. Long e Double hanno famiglie analoghe. Il nome indica la direzione della conversione. Per esempio, ToIntFunction<String> lunghezza = String::length descrive da una stringa a un int. Function<String, Integer> è anch'essa valida ma usa il wrapper Integer; su milioni di elementi la distinzione può interessare. Sul singolo elemento, l'obiettivo è anzitutto avere un contratto comprensibile.
Comporre significa controllare l'ordine
Function.andThen crea una funzione che applica prima quella a sinistra e poi quella passata come argomento. compose fa il contrario: applica prima la funzione ricevuta e poi quella su cui è chiamato il metodo. Se pulisci elimina gli spazi e maiuscolo converte le lettere, pulisci.andThen(maiuscolo) rende esplicito l'ordine: pulisci, poi converti. maiuscolo.compose(pulisci) esprime lo stesso ordine da un altro punto di partenza. Function.identity() restituisce il valore che riceve e serve soprattutto quando una API richiede una funzione ma non vogliamo trasformare l'elemento.
Per vedere che l'ordine non è un dettaglio, prendiamo aggiungiPrefisso = testo -> "#" + testo e rimuoviPrimo = testo -> testo.substring(1). Applicare il prefisso e poi rimuovere il primo carattere riporta il testo di partenza; invertire i passaggi elimina invece il primo carattere originale e aggiunge #. Le funzioni composte non diventano automaticamente commutative perché sono pure. Prima di comporre, seguiamo un input concreto attraverso i passaggi e scriviamo l'output atteso. È il metodo “mattone dopo mattone” applicato alla pipeline che incontreremo nel capitolo 18.
Predicate.and e Predicate.or combinano condizioni con la normale logica booleana e arresto anticipato: nel caso di and, se la prima condizione è falsa, la seconda non serve. negate rovescia il risultato. Un esempio: un titolo è valido se nonVuoto.and(abbastanzaBreve).test(titolo) è vero. Se nonVuoto esclude null con testo != null, il secondo predicato può chiamare length() senza errore, purché l'ordine delle due condizioni rimanga quello voluto. Un nome come titoloValido racconta al lettore la regola complessiva; i predicati interni ne spiegano i pezzi.
Consumer.andThen esegue due azioni nell'ordine indicato. Qui gli effetti contano: stampare e poi salvare non è sempre equivalente a salvare e poi stampare. Se la prima azione lancia un'eccezione, la seconda non viene eseguita. Non esiste una “purezza automatica” delle interfacce funzionali: è il corpo concreto della lambda o del metodo referenziato a determinare se modifica stato, fa I/O o dipende dall'ora. Questo chiarisce anche perché Supplier<Integer> casuale = ... è un supplier legittimo pur non essendo una funzione pura: il valore può cambiare a ogni chiamata.
Il tipo bersaglio decide la forma della lambda
L'espressione testo -> !testo.isBlank() assume un significato preciso perché viene assegnata a Predicate<String>. Da quel tipo, il compilatore ricava che testo è una String e che il risultato deve essere un boolean. Se assegnassimo la stessa espressione a un'interfaccia con una firma incompatibile, la compilazione fallirebbe. Le parentesi intorno ai parametri possono essere omesse nel caso di un solo parametro con forma semplice; con due parametri, come nel BiConsumer dell'esempio, la lista va fra parentesi. Quando il corpo contiene più istruzioni, servono parentesi graffe e un return esplicito se la funzione produce un valore.
Un metodo sovraccarico che accetta due interfacce funzionali diverse può rendere ambigua una lambda: la stessa forma potrebbe adattarsi a entrambe. In quel caso non bisogna inventare una regola di precedenza basata sul nome dell'interfaccia. Un cast esplicito, una variabile intermedia con tipo dichiarato o API meglio distinte possono chiarire la scelta. È un motivo in più per progettare le firme pubbliche pensando anche a chi passerà lambda come argomenti.
Le interfacce funzionali standard non dichiarano in genere eccezioni checked nel loro metodo astratto. Se un'operazione passata a Function deve leggere un file e può lanciare IOException, non possiamo semplicemente far propagare quell'eccezione checked attraverso apply. Occorre gestirla nel corpo, scegliere un'interfaccia propria che dichiari throws oppure spostare la lettura fuori dalla trasformazione. Catturare l'eccezione e sostituirla con un valore vuoto senza spiegazione cancellerebbe un errore reale. Le regole del capitolo 12 valgono anche quando il codice è scritto in una lambda.
Funzioni che restituiscono funzioni
Una funzione può restituire un'altra funzione. Per esempio, un metodo potrebbe ricevere una soglia e restituire un Predicate<Integer> che controlla se un numero la supera. La funzione restituita cattura il valore della soglia e potrà essere usata più tardi. Questa è una forma concreta di funzione di ordine superiore: un comportamento è passato o restituito come valore tipizzato. Non occorre introdurre una nuova grammatica del linguaggio; si usano interfacce funzionali, generics e lambda già viste.
Se scrivessimo Predicate<Integer> maggioreDiDieci = maggioreDi(10);, il nome del metodo racconta che cosa viene costruito e il tipo racconta quale domanda potremo porre. Un'espressione annidata di lambda potrebbe essere più compatta, ma meno leggibile. La scelta editoriale del libro resta quella usata nei capitoli precedenti: dare un nome alle idee che il lettore dovrà ricordare, non premiare il minor numero di caratteri.
Approfondimento – Currying. In teoria, il currying trasforma una funzione di più argomenti in una catena di funzioni ciascuna con un argomento. In Java possiamo rappresentare l'idea con
Function<A, Function<B, R>>, ma questa forma non è automaticamente migliore diBiFunction<A, B, R>. Diventa utile solo quando fissare il primo argomento crea un comportamento riusabile e leggibile. È un concetto facoltativo per il percorso principale.
Una trasformazione leggibile
Il programma completo prepara alcuni titoli: elimina gli spazi ai bordi, converte in maiuscolo, scarta il testo vuoto e stampa soltanto i risultati abbastanza lunghi. Non è un problema che richieda necessariamente le lambda; è piccolo proprio per isolare le decisioni. La figura 16.1 mostra le due trasformazioni e il filtro come passaggi distinti.

Function<String, String> pulisci = String::strip;
UnaryOperator<String> maiuscolo = String::toUpperCase;
Function<String, String> prepara = pulisci.andThen(maiuscolo);
Predicate<String> nonVuoto = testo -> !testo.isBlank();
Function<String, String> descrive una funzione che riceve una stringa e ne restituisce una. String::strip è un method reference: dice di usare il metodo strip della stringa ricevuta. È leggibile qui perché il nome del metodo comunica già l'operazione. La forma lambda equivalente sarebbe testo -> testo.strip(). UnaryOperator<String> è una specializzazione di Function<String, String> per input e output dello stesso tipo. andThen costruisce una nuova funzione: prima esegue pulisci, poi maiuscolo. Se invertissimo l'ordine in questo caso otterremmo lo stesso testo per molti input, ma non è una proprietà generale delle funzioni: l'ordine va scelto in base al significato delle trasformazioni.
Predicate<String> rappresenta una domanda con risposta booleana. Nel codice, testo -> !testo.isBlank() è una lambda con un parametro. La parola a sinistra della freccia è una variabile locale della lambda; l'espressione a destra produce il risultato. Potremmo combinare predicati con and, or e negate, ma una catena lunga di condizioni anonime diventerebbe difficile da spiegare. Quando la condizione ha un nome del dominio, un metodo ordinario con quel nome può essere la scelta più chiara.
La stampa è affidata a un BiConsumer<String, Integer>, che riceve testo e lunghezza e non restituisce un valore. Nel programma viene invocato con accept. Consumer, BiConsumer, Supplier, Predicate, Function, UnaryOperator e le varianti primitive sono famiglie di interfacce in java.util.function. Una variante come IntPredicate evita il boxing quando il dato è un int; non occorre però sostituire meccanicamente ogni tipo con una variante primitiva. Prima si chiarisce quale relazione fra input e output serve.
Il programma stampa JAVA: 4 e 120. Il titolo " Go " diventa GO, ma non raggiunge la lunghezza minima di 3. La stringa di soli spazi diventa vuota e viene scartata. Il valore 120 proviene dalla seconda parte dell'esempio, dedicata alla ricorsione.
Seguire i tipi attraverso una trasformazione completa
Il programma DemoFunzioni.java contiene in poche righe quasi tutte le idee del capitolo. Rileggiamolo come leggeremmo il percorso di un dato in una applicazione reale. L'input " Java " entra in pulisci, che restituisce "Java"; entra poi in maiuscolo, che restituisce "JAVA". Il predicato nonVuoto risponde true. La condizione sulla lunghezza confronta 4 con lunghezzaMinima, che vale 3, e lascia eseguire stampa.accept. La stampa JAVA: 4 è un effetto collaterale dichiarato dalla scelta di BiConsumer. Il programma distingue così tra trasformazione di un valore, decisione booleana e azione che interagisce con l'esterno.
Seguiamo invece " Go ": dopo strip otteniamo "Go", poi "GO"; il predicato non vuoto è ancora vero, ma la lunghezza 2 non raggiunge la soglia 3. La stringa formata da un solo spazio diventa vuota già nella prima trasformazione e viene fermata dal predicato. Se modificassimo il programma per controllare la lunghezza prima di strip, gli spazi conterebbero e la decisione potrebbe cambiare. La posizione di un filtro nella pipeline non è solo una possibile ottimizzazione: può essere parte del significato. Per questo formuliamo il contratto con parole precise, per esempio “titolo pulito di almeno tre caratteri”, prima di scegliere l'ordine delle chiamate.
Possiamo anche sostituire la soglia locale con una funzione restituita da un metodo: Predicate<String> lungoAlmeno(int minimo) { return testo -> testo.length() >= minimo; }. Se chiediamo lungoAlmeno(3), la soglia è fissata mentre il testo varierà a ogni chiamata di test. La firma del metodo racconta due tempi diversi: prima configuriamo la regola, poi la applichiamo. È un caso in cui la closure è utile per modellare una scelta, non soltanto per mostrare un meccanismo del linguaggio. Se il valore minimo deve cambiare durante l'esecuzione, invece, creare un nuovo predicato o usare un oggetto con stato esplicito sarà più onesto che tentare di aggirare la regola effectively final.
Un contratto funzionale per validare, non solo per calcolare
Immaginiamo che un sistema accetti nomi utente. Le regole richieste oggi sono “non vuoto”, “almeno quattro caratteri” e “senza spazi”. Possiamo rappresentarle con tre Predicate<String> e comporle con and. Prima, però, dobbiamo decidere che cosa fare con null: chiamare isBlank() su null lancia un'eccezione. Un primo predicato testo -> testo != null protegge quelli successivi grazie all'arresto anticipato di and. A quel punto l'insieme delle condizioni può essere verificato su null, " ", "anna" e "an na". Quattro dati scelti per coprire casi differenti sono più istruttivi di una sola stringa valida.
Predicate<String> presente = testo -> testo != null;
Predicate<String> nonVuoto = testo -> !testo.isBlank();
Predicate<String> lungo = testo -> testo.length() >= 4;
Predicate<String> senzaSpazi = testo -> !testo.contains(" ");
Predicate<String> nomeValido = presente.and(nonVuoto).and(lungo).and(senzaSpazi);
La regola non è perfetta: contains(" ") controlla soltanto lo spazio ordinario, non ogni carattere di spaziatura. Se il requisito è “nessun carattere whitespace”, va scelta una verifica diversa e vanno definiti i caratteri che il dominio considera proibiti. Questa osservazione è un esempio di trasferimento: la composizione funziona, ma il problema reale chiede una definizione più accurata. È anche il motivo per cui una regola di business complessa può meritare un metodo o un oggetto nominato, invece di restare un concatenamento anonimo che nessuno sa aggiornare.
Il risultato di una funzione dipende da tutto ciò che legge
La definizione di funzione pura sembra semplice finché i parametri sono numeri immutabili. Prendiamo int totale(List<Integer> valori): se il metodo legge la lista e ne calcola la somma senza modificarla, è puro rispetto a una fotografia stabile della lista. Ma se un altro codice può modificare la stessa lista fra due chiamate, i parametri hanno lo stesso riferimento e tuttavia contenuti diversi. Dire soltanto “stessi argomenti” diventa ambiguo. Per ragionare sulla purezza dobbiamo considerare lo stato osservabile raggiungibile attraverso gli argomenti. Una copia immutabile costruita con List.copyOf può dare un input più stabile, purché anche i suoi elementi non portino stato mutabile rilevante.
La trasparenza referenziale è una prova mentale utile su un'espressione concreta. calcolaIVA(100) può essere sostituito con il suo risultato solo se aliquota, arrotondamento e altri dati letti sono stabiliti dagli argomenti o da valori immutabili noti. Se il metodo consulta una configurazione modificabile o la data corrente, due chiamate apparentemente uguali possono produrre risultati diversi. Non dobbiamo eliminare tali funzioni da un programma: dobbiamo rendere visibile la dipendenza, per esempio passando aliquota e data come argomenti, e lasciare che il livello esterno si occupi di leggere configurazione e orologio. Così il nucleo del calcolo torna verificabile con esempi ripetibili.
Box – Effetto non significa errore. Scrivere un file, inviare una richiesta HTTP o aggiornare un contatore sono effetti necessari in molte applicazioni. Il problema è nasconderli dentro una funzione chiamata
normalizzaTestoo in un predicato che sembra limitarsi a rispondere vero/falso. Un nome e un tipo adeguati aiutano, ma occorre anche un contratto: quando avviene l'effetto, quante volte può avvenire e come si segnala un fallimento. Queste domande diventano decisive se il comportamento è consegnato a un'altra API che controlla il momento della chiamata.
Purezza, immutabilità ed effetti
Una funzione pura produce lo stesso risultato per gli stessi argomenti e non cambia uno stato osservabile all'esterno. testo -> testo.strip() è un buon esempio: String è immutabile, e la trasformazione restituisce un valore. La stampa, invece, è un effetto collaterale intenzionale: scrive sull'output del programma. Non va trattata come un difetto da eliminare sempre; va collocata dove il lettore può vederla e dove non sorprende chi riusa la funzione.
La trasparenza referenziale è la possibilità, in un dato contesto, di sostituire una chiamata con il suo risultato senza cambiare il comportamento del programma. Se somma(5, 5) è pura e restituisce 10, usare 10 al suo posto non cambia il risultato. Se la funzione incrementa un contatore globale ogni volta che viene chiamata, la sostituzione perderebbe quell'effetto e non sarebbe equivalente. Nel codice Java, questa prova ci aiuta a riconoscere una dipendenza nascosta prima che renda un calcolo difficile da prevedere.
Nota bene – Immutabilità del riferimento e dell'oggetto. Un riferimento
finalnon può essere riassegnato, ma l'oggetto a cui punta può ancora essere modificabile. Per una funzione pura non basta scriverefinal: occorre capire quali oggetti vengono letti o mutati e quali effetti possono essere osservati da fuori.
Le funzioni pure sono più semplici da provare e comporre perché non dipendono dall'ordine di chiamate non dichiarate. Tuttavia un'applicazione deve leggere dati, registrare eventi e comunicare con l'esterno. Il criterio pratico è tenere le trasformazioni pure dove aiutano e confinare gli effetti in punti riconoscibili, non sostenere che Java o gli stream eliminino automaticamente gli effetti.
La cattura delle variabili locali
Nel programma, la lambda non legge lunghezzaMinima direttamente, perché il confronto è nel ciclo; potremmo però scrivere Predicate<String> abbastanzaLungo = testo -> testo.length() >= lunghezzaMinima;. La lambda cattura allora il valore della variabile locale. Java richiede che una variabile locale catturata sia final o effectively final: può mancare la parola final, ma dopo l'assegnazione iniziale non deve essere riassegnata. Se scrivessimo lunghezzaMinima++ più avanti nello stesso metodo, il compilatore rifiuterebbe la cattura.
La regola non rende automaticamente immutabile l'oggetto catturato. Una lambda può avere un riferimento finale a una lista e modificarne gli elementi, ma questa possibilità va usata con giudizio: rende il risultato dipendente da uno stato esterno e può creare problemi nei flussi paralleli. Una closure, nel senso utile qui, è un comportamento che conserva l'accesso ai valori del contesto in cui è stato creato. In Java occorre leggere questo concetto insieme alla regola delle variabili locali catturate e alla distinzione fra riferimento e oggetto.
Le lambda possono apparire dentro cicli, chiamate e assegnazioni. Non sono sempre la forma più chiara. Se il corpo ha molti rami, più effetti o un significato che merita un nome, un metodo ordinario spesso riduce il lavoro del lettore. Un method reference è utile quando sostituisce una lambda ovvia; non vale la pena usarlo se costringe a decifrare una firma senza contesto.
La cattura: un comportamento che conserva il contesto
Torniamo al metodo aggiungi(int incremento) del programma. incremento è un parametro locale: la sua normale visibilità termina quando il metodo ritorna. Eppure l'Operazione restituita può essere eseguita dopo quel ritorno. La lambda continua a usare il valore necessario al suo calcolo. Questa è la situazione concreta per cui parliamo di closure: un comportamento porta con sé ciò che gli serve del contesto lessicale in cui è stato definito. Non occorre immaginare che tutto lo stack del metodo rimanga vivo. Occorre capire quale valore è stato catturato e quali regole rendono sicura quella cattura.
static Operazione aggiungi(int incremento) {
    return (a, b) -> a + b + incremento;
}

Operazione conDue = aggiungi(2);
int risultato = conDue.esegui(10, 3); // 15
incremento è effectively final: dopo aver ricevuto il valore, nel metodo non viene riassegnato. Se aggiungessimo incremento++; dopo la definizione della lambda, il compilatore rifiuterebbe il programma. La regola vale anche se la riassegnazione è in un ramo che ci sembra improbabile: il compilatore controlla la struttura del metodo. Per una variabile locale catturata, la lambda osserva il valore necessario alla propria esecuzione e non una casella locale che il chiamante possa cambiare più tardi. La differenza emerge soprattutto quando il comportamento sopravvive al metodo che lo ha creato.
Le variabili di istanza seguono un'altra strada. Nel programma DemoCattura.java, l'oggetto possiede il campo totale; il metodo prepara(3) restituisce un IntSupplier che somma 3 al campo ogni volta che viene invocato. Le due chiamate stampano 3 e 6. L'incremento locale è stabile, ma il campo dell'oggetto cambia: la lambda usa il medesimo oggetto attraverso this. Questa è una lambda con effetto. È legale e talvolta utile, ma le chiamate non sono intercambiabili: la seconda dipende dalla prima. In presenza di più thread servirà anche una regola di sincronizzazione, tema del capitolo sulla concorrenza.
IntSupplier prossimo = conto.prepara(3);
System.out.println(prossimo.getAsInt()); // 3
System.out.println(prossimo.getAsInt()); // 6
Un campo statico è accessibile allo stesso modo in cui lo è in un metodo ordinario, se la visibilità lo consente. Una lambda può leggerlo e modificarlo; ciò non la rende pura e non fa scattare la regola effectively final delle variabili locali. Tuttavia, il fatto che una modifica compili non significa che sia una buona scelta. Un contatore globale usato in un filtro rende il risultato dipendente dall'ordine di valutazione e difficile da riprodurre. Per questo, quando una lambda viene passata a una pipeline, è necessario dichiarare se osserva soltanto l'elemento corrente oppure usa uno stato che cambia.
Box –
finalnon congela una lista. Scriviamofinal List<String> nomi = new ArrayList<>();e poiConsumer<String> aggiungi = nomi::add;. Il riferimentonominon può essere riassegnato, ma la lista può essere modificata. La lambda è valida e produce un effetto. Se lo stesso consumer fosse chiamato da più thread senza coordinamento, la parolafinalnon proteggerebbe la struttura interna della lista. La protezione richiesta dipende dall'oggetto condiviso e dalle sue regole, non dall'immutabilità del riferimento locale.
Lambda e classe anonima: che cosa indica this
Una classe anonima è un nuovo oggetto con il proprio this; una lambda usa il this della classe che la contiene. Possiamo verificarlo senza affidarci a una definizione astratta. Una classe Etichetta ha un campo nome = "esterna". All'interno di un suo metodo, creiamo una classe anonima con un proprio campo nome = "anonima" e un metodo che stampa this.nome. Poi creiamo una lambda che stampa this.nome. La prima stampa è anonima, la seconda esterna. La lambda non crea un nuovo ambito per this come lo crea la classe anonima.
Runnable anonima = new Runnable() {
    private final String nome = "anonima";
    @Override public void run() { System.out.println(this.nome); }
};
Runnable lambda = () -> System.out.println(this.nome);
Questo frammento è valido dentro un metodo di istanza di Etichetta; non è pensato per stare in un metodo static, dove non esiste un this dell'istanza esterna. Anche super in una lambda si risolve nel contesto lessicale che la racchiude. Un'altra differenza pratica è che una classe anonima può implementare un'interfaccia con più metodi, mentre una lambda richiede un tipo bersaglio funzionale. Non si deve trasformare meccanicamente ogni classe anonima in lambda solo perché il corpo visibile è breve: controlliamo campi, metodi, this, super e identità dell'oggetto.
Quando confrontiamo lambda e classi anonime, dobbiamo distinguere il comportamento garantito dai dettagli di prestazione e allocazione: la specifica definisce il comportamento osservabile delle lambda, non promette una strategia fissa di allocazione valida per tutte le JVM. La scelta fra classe anonima e lambda parte dal contratto e dalla leggibilità. Se un profilo reale dimostra un costo importante in un punto caldo, si misura quella implementazione sulla JVM e sul carico pertinenti. In assenza di tali dati, un'affermazione assoluta sulla velocità insegna una scorciatoia ingannevole.
Riferimenti a metodi: quattro problemi, quattro forme
Quando la lambda passa i propri argomenti a un metodo esistente senza aggiungere una logica propria, possiamo spesso usare ::. Il riferimento a metodo conserva il tipo bersaglio: System.out::println non è un tipo autonomo, ma può essere assegnato per esempio a Consumer<String>. Le quattro forme più utili si distinguono da chi possiede il metodo e da dove viene preso il ricevitore.
La prima forma, NomeClasse::metodoStatico, usa un metodo statico. Integer::sum può implementare BinaryOperator<Integer> perché riceve due Integer che Java converte ai parametri int del metodo e restituisce un risultato adattabile a Integer. Nel nostro programma DemoPercorsoLambda::somma implementa l'interfaccia propria Operazione. Le firme non devono coincidere come stringhe di testo: il compilatore applica le regole di compatibilità dei parametri e del risultato, compresi adattamenti permessi come boxing e unboxing. Se i tipi non si accordano, l'errore avviene alla compilazione.
La seconda forma, oggetto::metodoIstanza, ha già un ricevitore. System.out::println conserva il riferimento a System.out usato per costruire quel method reference; il parametro che arriverà a Consumer.accept diventerà l'argomento di println. Un esempio di dominio potrebbe essere catalogo::registra assegnato a un Consumer<Libro> se catalogo è un oggetto con il metodo registra(Libro). Qui il ricevitore è scelto quando prepariamo il comportamento. Se catalogo è null, la costruzione del riferimento a metodo di istanza produce un errore: non equivale a una chiamata posticipata su un riferimento forse nullo.
La terza forma, NomeClasse::metodoIstanza, non possiede ancora il ricevitore. Il primo argomento dell'interfaccia funzionale diventa l'oggetto su cui chiamare il metodo. String::length può diventare Function<String, Integer>: quando apply("Java") viene chiamato, la stringa ricevuta è il ricevitore di length(). String::startsWith può diventare BiPredicate<String, String>: il primo argomento è il testo da interrogare, il secondo è il prefisso. Leggere i due ruoli nell'ordine giusto evita di invertire la domanda. La forma lambda equivalente, (testo, prefisso) -> testo.startsWith(prefisso), è una prova semplice della corrispondenza.
La quarta forma, NomeClasse::new, richiama un costruttore. Supplier<ArrayList<String>> fabbrica = ArrayList::new produce una nuova lista a ogni get(), mentre Function<String, StringBuilder> crea = StringBuilder::new usa il costruttore che riceve una stringa. Possiamo anche usare un riferimento a costruttore di array, String[]::new, con un'interfaccia che riceve la dimensione e restituisce un array. Non è necessario memorizzare tutte le firme: guardiamo il tipo bersaglio, individuiamo gli argomenti disponibili e verifichiamo quale costruttore è applicabile.
Verifica guidata. Per
BiPredicate<String, String> iniziaCon = String::startsWith,iniziaCon.test("Java", "Ja")valetrue; scambiando i due argomenti valefalse. PerFunction<String, Integer> lunghezza = String::length,lunghezza.apply("Java")vale 4. Se il riferimento a metodo rende meno visibile l'ordine degli argomenti, usiamo la lambda esplicita. La leggibilità è una parte del contratto didattico.
Un riferimento a metodo sovraccarico può essere risolto dal tipo bersaglio, ma talvolta più firme restano applicabili e il compilatore segnala un'ambiguità. L’ambiguità di overload è un problema di compilazione: il chiamante non può scegliere in modo univoco la firma. Se abbiamo due overload processa(Callable<String>) e processa(Supplier<String>), l'espressione () -> "ok" è compatibile con entrambi. Possiamo usare un cast al tipo desiderato, ma nomi distinti per operazioni dal significato diverso sono di solito più chiari e più stabili.
Ricorsione: un problema che richiama sé stesso
fattoriale nel programma mostra la ricorsione: un metodo chiama sé stesso su un problema più piccolo. Il caso n == 0 interrompe la discesa; per n > 0, il risultato è n moltiplicato per fattoriale(n - 1). Per 5, le chiamate arrivano a zero e risalgono producendo 1, 1, 2, 6, 24 e 120.
Disegniamo un triangolo fatto di righe di punti: permette di vedere che cosa cambia fra un caso e il successivo. Nella figura, T(n) è il totale dei punti dopo aver aggiunto la riga numero n. Non è l'area geometrica di un triangolo continuo; è il conteggio di unità discrete disposte a triangolo.
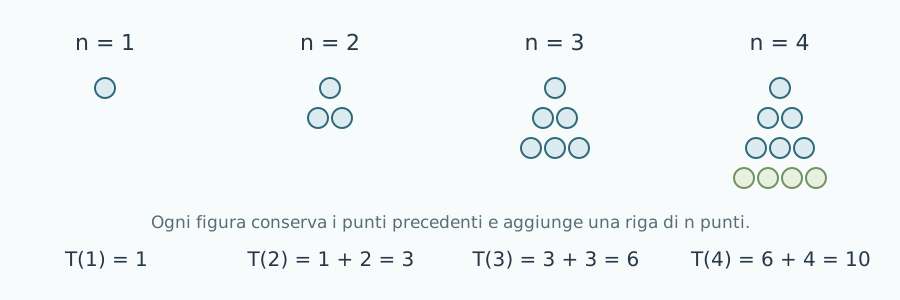
T(n) si conservano i punti di T(n − 1) e si aggiunge una riga di n punti. Il colore diverso dell'ultima riga del quarto disegno mostra il passo ricorsivo.Il caso iniziale è T(0) = 0: nessuna riga, nessun punto. Per un numero intero positivo n, la regola è T(n) = T(n − 1) + n. In questa formula n è il numero di punti nella nuova riga, T(n − 1) è il totale già costruito e il risultato è un conteggio di punti, senza unità fisiche. Seguendo i passi della figura otteniamo T(1) = 1, T(2) = 1 + 2 = 3, T(3) = 3 + 3 = 6 e T(4) = 6 + 4 = 10. La formula vale qui per n interi non negativi; non descrive una misura continua né un ingresso negativo.
Il programma completo DemoTriangolari.java traduce direttamente la regola: per zero restituisce zero, altrimenti somma n al risultato di triangolare(n - 1). Per triangolare(4), la JVM attende il risultato di 3, che attende quello di 2, poi di 1 e infine di 0. Risalendo, le somme producono 1, 3, 6 e 10; sono proprio le quattro righe stampate da main. Math.addExact segnala un overflow di int, ma non impedisce l'esaurimento dello stack per valori molto grandi: questi sono due limiti diversi. Una versione con ciclo può calcolare lo stesso totale con profondità di chiamata costante. Anche la formula chiusa n(n + 1)/2 richiede attenzione all'overflow del prodotto prima della divisione; la scorciatoia algebrica non elimina automaticamente i limiti dei tipi Java.
I due esempi controllano rischi diversi: DemoTriangolari rifiuta un valore negativo e usa Math.addExact nella somma ricorsiva; il metodo fattoriale di DemoFunzioni usa Math.multiplyExact nel prodotto. In entrambi i casi un'eccezione per overflow evita un risultato intero silenziosamente errato. Non basta però a rendere la ricorsione adatta a numeri enormi: molte chiamate annidate consumano stack, e un caso senza arresto può causare StackOverflowError. Java non promette una trasformazione generale della ricorsione di coda in un ciclo. Per somme e prodotti lineari molto grandi, un ciclo può essere più semplice e più prudente.
La composizione incontrata con andThen costruisce una trasformazione da operazioni più piccole; la ricorsione costruisce una soluzione da problemi più piccoli. In entrambi i casi il passo va letto e verificato: nella composizione conta l'ordine delle funzioni, nella ricorsione conta il caso che ferma le chiamate. compose applica le funzioni nell'ordine opposto rispetto a andThen nella scrittura. Il confronto prepara il controllo del costo della ricorsione, senza trasformare le due tecniche in sinonimi.
Ricorsione: costi, limiti e alternative
La figura 16.2 ci ha dato il caso base T(0) = 0 e il passo T(n) = n + T(n - 1) per n > 0. Ora guardiamo il costo di quelle chiamate. Se manca il caso base o se il passo non vi si avvicina, le chiamate continuano fino a esaurire lo stack. Se n è negativo, la regola matematica scelta nel capitolo non lo definisce: il programma deve rifiutare quell'ingresso invece di scendere indefinitamente.
Per T(4), la pila delle chiamate contiene nell'ordine T(4), T(3), T(2), T(1), T(0). Poi i risultati risalgono: 0, 1, 3, 6, 10. La JVM conserva il punto in cui ogni chiamata deve riprendere e i suoi dati locali. Questo spiega perché la memoria usata cresce con la profondità, anche se ogni riga di codice è breve. Nel programma DemoTriangolari.java, Math.addExact intercetta il superamento del limite di int; non intercetta uno stack troppo profondo. Sono due problemi separati: uno riguarda il valore calcolato, l'altro la struttura dell'esecuzione.
Una versione iterativa mantiene un accumulatore: parte da zero e somma 1, 2, ... n. Per n = 4 ottiene gli stessi valori intermedi della risalita ricorsiva senza mantenere quattro chiamate in attesa. La formula chiusa T(n) = n(n + 1)/2 si ricava accostando due triangoli uguali: insieme formano un rettangolo di lati n e n + 1, quindi un triangolo ne contiene metà dei punti. Non conviene tradurre la formula ingenuamente in int con n * (n + 1) / 2, perché il prodotto intermedio può andare in overflow anche quando un ragionamento algebrico permetterebbe di dividere prima. Per input grandi scegliamo un tipo adeguato, controlliamo le operazioni e consideriamo i limiti di memoria e tempo. L'obiettivo qui è imparare a scegliere una rappresentazione, non dichiarare la ricorsione sempre migliore o sempre peggiore.
La funzione fattoriale del primo programma ha un altro caso base, 0! = 1, e per n > 0 usa n! = n × (n-1)!. Nel codice Math.multiplyExact avvisa quando un risultato non entra più in int. Scriviamo una piccola tabella a mano: 0! = 1, 1! = 1, 2! = 2, 3! = 6, 4! = 24. Poi confrontiamola con l'esecuzione. Questa verifica è più istruttiva di una stampa finale isolata, perché ci dice dove il risultato potrebbe divergere dalla regola. Il trasferimento è un metodo che attraversa un albero: anche lì serve un caso base, per esempio un nodo assente, e un passo che visita sottoalberi più piccoli.
Applicazione parziale e currying, quando servono davvero
Supponiamo che un negozio debba applicare spesso uno sconto del 10 per cento. Una funzione generale calcola(prezzo, percentuale) riceve due valori; una funzione scontoDieci conserva la percentuale e riceve soltanto il prezzo. In Java possiamo costruirla con un metodo che restituisce UnaryOperator<BigDecimal> o con un'interfaccia propria, purché le regole monetarie siano definite: arrotondamento, scala e significato della percentuale. Il vantaggio è che la regola “10 per cento” diventa un comportamento nominato che può essere riutilizzato nei punti del programma in cui cambia solo il prezzo.
Il currying in senso stretto trasforma una funzione di due argomenti in una funzione che ne riceve uno e restituisce un'altra funzione: Function<A, Function<B, R>>. La applicazione parziale fissa invece alcuni argomenti di una funzione e ne produce una più specifica. Nell'uso quotidiano Java, i due concetti sono spesso avvicinati, ma non sono identici. Il metodo aggiungi(2) è un esempio pratico di fissare un valore nel comportamento restituito; non abbiamo bisogno di fingere che ogni metodo a più argomenti debba essere riscritto come una catena di funzioni. BiFunction è spesso la firma più chiara per un'operazione binaria ordinaria.
static Function<Integer, Integer> sommaCon(int incremento) {
    return valore -> valore + incremento;
}
Function<Integer, Integer> sommaTre = sommaCon(3);
int sette = sommaTre.apply(4);
Seguiamo il dato: sommaCon(3) non calcola ancora il risultato finale; prepara una funzione che ricorda 3. apply(4) fornisce il secondo valore e produce 7. Possiamo verificare sommaTre.apply(10) == 13 senza ricreare la funzione. Il trasferimento a una regola di validazione è analogo: lunghezzaAlmeno(8) può restituire un Predicate<String> che controlla molte password candidate secondo una soglia scelta una volta. Se la regola non è riusata o la chiamata annidata diventa meno leggibile di un semplice metodo con due argomenti, il passaggio intermedio non aggiunge valore.
Pipeline e monadi: una distinzione necessaria
Chiamare “monade” qualsiasi classe di funzioni concatenabili è una semplificazione troppo larga: molte funzioni si possono concatenare senza formare una monade. Per il nostro percorso è sufficiente comprendere la pipeline: l'uscita di un passaggio diventa l'ingresso del successivo, con contratti che rendono possibile la composizione. pulisci.andThen(maiuscolo) è una pipeline di due trasformazioni; una pipeline Stream aggiunge una sorgente e una terminale. La concatenazione da sola non promette parallelismo: gli stream sequenziali eseguono il lavoro nel thread chiamante, e i passaggi possono essere fusi o ottimizzati dall'implementazione.
Approfondimento – Per chi incontrerà il termine “monade”. In programmazione funzionale il termine riguarda un modo disciplinato di comporre calcoli che producono valori in un contesto, con operazioni e leggi precise.
Optionalrappresenta per esempio un possibile valore assente e permette di concatenare trasformazioni che rispettano quel contesto tramitemapeflatMap. Ma conoscere il nome non è una precondizione per usareOptionalcorrettamente; e dire che ogni pipeline è una monade sarebbe falso. Qui impariamo prima a riconoscere il problema concreto dell'assenza di valore e il contratto delle operazioni. I concetti teorici torneranno utili quando avremo casi reali con cui confrontarli.
Optional: un risultato che può mancare
Un metodo trovaLibro(String codice) può non trovare nulla. Restituire null obbliga ogni chiamante a ricordare una convenzione non espressa nel tipo; dimenticarla porta a NullPointerException. Restituire Optional<Libro> mette l'assenza nella firma. Optional.empty() rappresenta il caso assente; Optional.of(libro) richiede un valore non nullo; Optional.ofNullable(libro) accetta il caso nullo quando dobbiamo adattare codice esistente. Non usiamo Optional.ofNullable per nascondere indiscriminatamente errori di progettazione: lo usiamo quando l'assenza è un esito normale e dichiarato.
Optional<String> titolo = Optional.of(" Java ");
String visualizzato = titolo.map(String::strip)
        .filter(t -> !t.isEmpty())
        .orElse("senza titolo");
La map trasforma il valore se è presente e lascia vuoto l'Optional se non lo è. Il filter conserva il valore soltanto se passa la condizione. orElse fornisce un valore alternativo. Se l'alternativa richiede lavoro, orElseGet(() -> calcolaAlternativa()) la calcola solo quando serve; l'argomento di orElse, essendo una normale espressione Java, viene invece valutato prima della chiamata. orElseThrow è opportuno quando l'assenza viola un contratto già controllato o quando un'eccezione esplicita comunica il problema. Chiamare get() senza verificare la presenza riporta il rischio al chiamante e perde gran parte della chiarezza ottenuta con il tipo.
Optional non è una collezione da usare per ogni campo o per ogni parametro. È particolarmente utile come valore di ritorno di una ricerca. Nel capitolo 18 incontreremo findFirst e findAny, che possono non trovare elementi e quindi restituiscono Optional. La domanda corretta non è “come estraggo subito il valore?”, ma “che cosa deve fare il programma quando il valore manca?”. Un catalogo può mostrare “non trovato”; un processo di pagamento può fermarsi con un errore; una ricerca esplorativa può proseguire. Queste sono decisioni del dominio, non dettagli dell'API.
Dai valori opzionali alle funzioni di trasformazione
Un Optional<String> può contenere il titolo trovato da una ricerca. map(String::strip) lo pulisce se è presente, mentre flatMap serve quando la funzione chiamata restituisce già un Optional. Supponiamo che cercaAutore(String titolo) restituisca Optional<Autore>. Se scriviamo titolo.map(this::cercaAutore), otteniamo un Optional<Optional<Autore>>: un contenitore possibile intorno a un altro contenitore possibile. flatMap(this::cercaAutore) conserva un solo livello di assenza. Questo passaggio anticipa la stessa differenza fra map e flatMap negli stream: guardiamo sempre il tipo prodotto dalla funzione interna, non soltanto il nome del metodo esterno.
La scelta dell'alternativa in Optional è parte della soluzione. orElse("sconosciuto") è adatto se l'etichetta sostitutiva è già disponibile; orElseGet(this::caricaEtichetta) rimanda un lavoro potenzialmente costoso finché l'Optional non è vuoto. Se l'assenza è un errore, orElseThrow(() -> new IllegalArgumentException("titolo assente")) esplicita il fallimento. Se dobbiamo soltanto agire quando c'è un valore, ifPresent accetta un Consumer. La scelta non è “qual è il metodo più moderno?”, ma “quale risposta richiede il problema in presenza e in assenza?”.
Ci sono anche limiti deliberati: Optional non dovrebbe diventare automaticamente un campo di ogni entità, né un modo per accettare null ovunque. Alcune librerie di serializzazione e persistenza hanno convenzioni proprie; una firma con Optional non le sostituisce. Il valore maggiore è nella chiamata a un metodo che può legittimamente non trovare un risultato. Da qui il collegamento con findFirst nel capitolo successivo: l'assenza è un esito previsto e il chiamante deve gestirla.
Scelte di stile che proteggono il significato
Quando una lambda è lunga tre schermate, il lettore deve ricostruire insieme il significato dell'operazione e tutti i suoi rami. Un metodo nominato come calcolaPrezzoFinale può rendere la pipeline più chiara, purché il nome sia accurato e il corpo rimanga verificabile. Un riferimento a metodo va preferito quando spiega immediatamente l'azione; String::strip è chiaro, mentre una catena di riferimenti a metodi sovraccarichi con generics complessi può richiedere più sforzo della lambda esplicita. L'obiettivo editoriale è permettere al lettore di seguire dato in ingresso, trasformazione e risultato senza indovinare.
Per una regola importante del dominio, una piccola interfaccia propria può essere migliore di Predicate<Ordine>: RegolaSconto o ControlloOrdine possono esprimere un'intenzione che il generico test non comunica. Tuttavia, creare una nuova interfaccia per ogni lambda di una riga produce molto codice senza migliorare il modello. Prima proviamo le interfacce standard; se il nome o il contratto delle eccezioni non bastano, definiamo il tipo di dominio. Anche qui il percorso è problema, scelta, verifica: un chiamante deve capire dalla firma quale comportamento fornire e che cosa può aspettarsi in uscita.
L'overload di metodi che accettano interfacce funzionali simili richiede attenzione. esegui(Supplier<String>) e esegui(Callable<String>) ricevono entrambi una lambda senza parametri che produce una stringa; la chiamata esegui(() -> "ok") è ambigua. Un cast risolve il caso locale, ma due nomi diversi possono chiarire la diversa semantica delle operazioni. Inoltre, Callable.call può dichiarare Exception, mentre Supplier.get no: anche quando l'espressione sembra identica, il contratto dell'errore cambia. Questo è un buon esempio di come la firma funzionale non sia solo una comodità sintattica.
Per valutare se una lambda è adatta a un'API, chiediamoci se può essere richiamata zero, una o più volte, se l'ordine è garantito, se può essere eseguita in un altro thread e se il chiamante si aspetta una funzione senza effetti. Comparator.compare, per esempio, può essere richiamato molte volte da un ordinamento. Un comparatore che cambia risposta in base a un contatore produce un ordine incoerente. Predicate in uno stream può essere saltato in alcune ottimizzazioni. Supplier dato a una cache può essere invocato solo quando manca il valore. Capire queste condizioni vale più che imparare a memoria tutte le forme di ->.
Verifica e trasferimento. Riprendi il problema iniziale dei prezzi: scrivi una
Operazioneper la differenza, passala acalcolae verifica il risultato con valori scelti da te. Poi prova a sostituirla conInteger::sum; spiega perché il metodo chiamante non cambia. Infine trasporta il modello a una lista di titoli: il lavoro comune attraversa i titoli, il comportamento variabile decide quali accettare. Se la decisione deve consultare un archivio esterno, rendi visibile quell'effetto e spiega come verificherai l'errore di accesso.
Una prova di trasferimento: classificare documenti
Un archivio riceve descrizioni testuali e deve assegnare una categoria in base al contenuto. Possiamo separare tre responsabilità: una Function<String, String> pulisce il testo, un Predicate<String> verifica che sia utilizzabile e una Function<String, Categoria> lo classifica. Prima di scrivere lambda, decidiamo i casi: descrizione null, soli spazi, testo valido ma categoria sconosciuta. Se la classificazione può fallire senza che il dato sia scorretto, il tipo di ritorno potrebbe essere Optional<Categoria>. Se invece un servizio remoto decide la categoria, l'operazione porta I/O, latenza ed errori; nasconderla in una lambda chiamata classifica non elimina queste responsabilità.
La prima verifica può essere completamente locale: tre stringhe, tre risultati attesi, nessuna rete. La seconda può sostituire il classificatore con una implementazione finta che restituisce categorie note. Questo mostra il vantaggio di passare un comportamento come argomento: possiamo cambiare la regola senza duplicare il percorso di pulizia e validazione. Il trasferimento dal problema dei prezzi a quello dei documenti è quindi reale: la struttura stabile attraversa i dati, la parte variabile è un comportamento tipizzato e le verifiche controllano entrambe le parti.
Tre errori di lettura da riconoscere prima che diventino difetti
Il primo errore è confondere la brevità sintattica con la purezza. x -> { contatore++; return x * 2; } è una lambda breve, ma dipende da un campo esterno e lo modifica. x -> x * 2 è una trasformazione senza quell'effetto. Quando leggiamo un comportamento passato come argomento, non fermiamoci alla freccia: individuiamo tutti i valori letti e scritti. Se è una regola di calcolo, chiediamoci se due chiamate con lo stesso input possono essere scambiate senza cambiare il risultato dell'applicazione. Se la risposta è no, documentiamo la dipendenza e verifichiamo l'ordine delle chiamate.
Il secondo errore è credere che @FunctionalInterface sia obbligatoria per usare una lambda. Un'interfaccia con un solo metodo astratto è funzionale anche senza annotazione. La annotiamo perché vogliamo proteggere l'intenzione del progetto: se l'interfaccia evolve, il compilatore deve avvertirci che le lambda esistenti perderebbero il loro contratto. È lo stesso motivo per cui @Override aiuta quando implementiamo un metodo: la dichiarazione esplicita permette al compilatore di controllare una scelta che altrimenti potrebbe restare soltanto nella nostra testa.
Il terzo errore è assegnare a un riferimento a metodo più chiarezza di quanta ne abbia. String::replaceAll richiede di sapere che il primo argomento della funzione bersaglio diventa la stringa su cui chiamare il metodo, mentre gli altri diventano gli argomenti della chiamata. Per un lettore che sta ancora imparando questo meccanismo, (testo, espressione, sostituto) -> testo.replaceAll(espressione, sostituto) può essere più chiaro. Inoltre replaceAll interpreta il primo parametro come espressione regolare, non come testo letterale; se il problema richiede una sostituzione letterale, replace è un'altra operazione. La forma più corta non corregge una scelta semantica sbagliata.
Verificare le funzioni con casi che discriminano
Per sommaCon(3), proviamo zero, un numero positivo e uno negativo. Il risultato atteso è rispettivamente 3, 7 per input 4 e 1 per input -2. Questi casi verificano che il valore fissato venga davvero aggiunto e che non sia confuso con un moltiplicatore o con una soglia. Per nomeValido, proviamo null, stringa vuota, quattro lettere senza spazi e quattro caratteri con uno spazio. La prova non mira a ripetere il corpo della lambda: mira a rappresentare diverse classi di input del problema.
Quando una funzione viene composta con un'altra, aggiungiamo un caso in cui cambiare l'ordine cambia il risultato. Se due trasformazioni commutano per tutti i dati del test, un ordine errato passerebbe inosservato. Per questo l'esempio con il prefisso e la rimozione del primo carattere è didatticamente più forte del solo strip seguito da toUpperCase. La regola si trasferisce a conversioni di unità, normalizzazioni, calcoli fiscali e validazioni: scegliere un input che distingua due implementazioni plausibili rende la verifica informativa.
Nel capitolo 17 incontreremo le collezioni che conservano i dati; nel capitolo 18 useremo i comportamenti tipizzati di queste pagine nelle pipeline. La distinzione costruita qui resta valida in entrambi: una funzione descrive una trasformazione, mentre l'API che la riceve decide quando e quante volte invocarla.
Per verificare
Compila ed esegui DemoFunzioni.java, DemoPercorsoLambda.java e DemoCattura.java con JDK 25. Modifica lunghezzaMinima da 3 a 2 e prevedi quale nuova riga comparirà. Poi sostituisci String::strip con la lambda equivalente e verifica che l'output resti uguale. Prima di eseguire DemoCattura, prevedi perché la seconda chiamata dà un risultato diverso dalla prima. Per controllare la ricorsione, scrivi su carta le chiamate di fattoriale(3) prima di eseguirle. Infine prova fattoriale(-1) in una copia del programma e spiega quale contratto è stato violato.