La build è verde; il problema resta
Il capitolo 29 ci ha consegnato un catalogo che si compila, supera cinque test e si avvia da un JAR e da un'applicazione impacchettata. È un progresso reale: un collega può ripetere quei passaggi. Possiamo però consegnare quel programma a chiunque carichi un file arbitrario? ArchivioTitoli usa uno stream di righe, normalizza i titoli e accumula tutto in una lista. Non impone un massimo alle righe lette, né al numero di titoli. Un file molto grande può consumare memoria; una riga enorme può essere letta prima che Titoli.normalizza la rifiuti. I cinque test non chiedevano questo comportamento, quindi il loro successo non risponde alla nuova domanda.
Il nostro caso di studio cambia ora una condizione: il file potrebbe arrivare da un utente e non essere fidato. Dobbiamo stabilire che cosa accettiamo, quanto lavoro siamo disposti a fare, che cosa registriamo quando qualcosa va storto e come raccogliamo prove se il processo rallenta. Queste decisioni intrecciano qualità, sicurezza e operabilità, ma non sono la stessa proprietà. Una regola di input corretta può essere scritta in codice illeggibile; un log dettagliato può esporre un dato riservato; una build pulita può distribuire una dipendenza vulnerabile. Per questo il capitolo continua il percorso del catalogo invece di offrire una lista di comandi da spuntare.
Definizione – Qualità osservabile. Correttezza significa rispettare il comportamento dichiarato. Leggibilità e manutenibilità riguardano la possibilità di comprendere e cambiare quel comportamento. Prestazioni riguardano tempo e risorse su un carico definito. Sicurezza riguarda il trattamento di dati, permessi e confini di fiducia. Operabilità significa poter capire e governare un programma in esecuzione. Nessuna cifra unica dimostra tutte queste proprietà: per ognuna dobbiamo dire quale evidenza cerchiamo.
La figura 30.1 collega cinque passi. Preveniamo un difetto fissando un contratto; lo rileviamo con test e strumenti; lo diagnostichiamo con prove; lo correggiamo in un cambiamento controllato; conserviamo una prova di regressione. La freccia torna all'inizio perché un nuovo requisito, come il file non fidato, modifica ciò che dobbiamo prevenire.
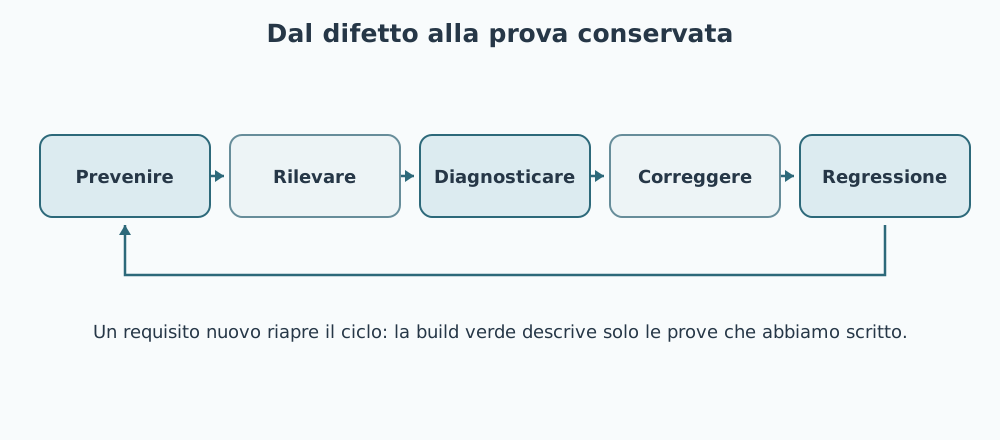
Un requisito nuovo obbliga a rivedere il codice
Nell'importatore del capitolo 29 il metodo Files.lines legge una riga per volta, ma questo non costituisce un limite di lunghezza: la libreria deve comunque formare la stringa della riga. Inoltre la lista cresce con il numero dei titoli. Se il file è interno, piccolo e controllato, il compromesso può essere ragionevole. Se invece l'utente può caricarlo, definiamo prima il contratto: nel nostro esperimento accettiamo al massimo cento titoli non vuoti e ottanta unità UTF-16 per riga. Il numero è una scelta dimostrativa; un servizio reale deve sceglierlo in base al dominio, ai costi, ai messaggi d'errore e alla capacità disponibile.
La figura 30.2 distingue i confini del file: percorso, byte, decodifica, righe, titoli normalizzati e oggetti del dominio. Ogni confine può fallire in modo diverso. Un percorso può uscire dalla directory permessa; byte malformati possono non essere testo UTF-8; una riga può essere troppo lunga; un titolo può essere sintatticamente valido ma non rispettare le regole del catalogo. Non basta un unico catch che trasformi tutto in «file non valido», perché così perdiamo la causa utile per decidere se correggere l'input, i permessi o il programma.

Il programma completo ImportazioneControllata lavora su un Reader, non su un percorso. Il chiamante decide da dove arrivano i caratteri; il metodo si occupa delle righe e dei limiti. Nel main usiamo StringReader per una prova piccola e indipendente dal file system. In un'applicazione reale si costruirebbe il Reader con una decodifica esplicita, per esempio Files.newBufferedReader(percorso, StandardCharsets.UTF_8), dopo aver definito quale percorso è autorizzato. Separare questi due compiti rende più facile provare il parser senza fingere di aver risolto il problema dei percorsi.
import java.io.BufferedReader;
import java.io.IOException;
import java.io.Reader;
import java.io.StringReader;
import java.util.ArrayList;
import java.util.List;

public final class ImportazioneControllata {
    private static final int MAX_RIGA = 80;
    private static final int MAX_TITOLI = 100;
    private static final System.Logger LOG =
            System.getLogger(ImportazioneControllata.class.getName());

    private ImportazioneControllata() {
    }

    public static List<String> leggi(Reader sorgente) throws IOException {
        List<String> titoli = new ArrayList<>();
        StringBuilder riga = new StringBuilder();
        try (BufferedReader lettore = new BufferedReader(sorgente)) {
            int letto;
            while ((letto = lettore.read()) != -1) {
                if (letto == '\n') {
                    aggiungi(riga, titoli);
                    riga.setLength(0);
                } else if (letto != '\r') {
                    if (riga.length() == MAX_RIGA) {
                        throw new IOException("Riga troppo lunga");
                    }
                    riga.append((char) letto);
                }
            }
            if (!riga.isEmpty()) {
                aggiungi(riga, titoli);
            }
        }
        LOG.log(System.Logger.Level.INFO,
                "Importati {0} titoli", titoli.size());
        return List.copyOf(titoli);
    }

    private static void aggiungi(StringBuilder riga, List<String> titoli)
            throws IOException {
        String titolo = riga.toString().strip().replaceAll("\\s+", " ");
        if (titolo.isEmpty()) {
            return;
        }
        if (titoli.size() == MAX_TITOLI) {
            throw new IOException("Troppi titoli");
        }
        titoli.add(titolo);
    }

    public static void main(String[] args) throws IOException {
        String dati = "  Java   moderno  \nÈ tempo di imparare\n";
        List<String> titoli = leggi(new StringReader(dati));
        System.out.println("Titoli validi: " + titoli.size());
    }
}
BufferedReader evita di chiedere un carattere alla sorgente fisica per ogni chiamata. Il ciclo legge un'unità char per volta: prima di aggiungerla a StringBuilder controlla se la riga ha già raggiunto ottanta unità. Così una riga di migliaia di caratteri non viene accumulata per intero nel nostro StringBuilder prima del rifiuto. Il lettore può comunque avere un proprio buffer interno di dimensione limitata; il contratto è sullo stato che il parser conserva e sul punto in cui interrompe la lettura, non sul fatto che nessun byte successivo sia mai stato prelevato dal sistema operativo. A ogni \n la riga viene normalizzata e inserita soltanto se non è vuota. \r viene ignorato per consentire il finale di riga CRLF del caso didattico. Questo semplice formato non è un parser universale: una regola su righe terminate solo da CR o su altri separatori andrebbe dichiarata e provata.
aggiungi controlla il numero di titoli prima di inserire il centunesimo. Se supera il limite, il metodo lancia IOException e la lista parziale non viene restituita. Il try-with-resources chiude il Reader passato: è parte del contratto del metodo, da documentare per non sorprendere chi volesse riutilizzare la stessa sorgente. List.copyOf evita che il chiamante modifichi la lista restituita; non rende però atomica una scrittura successiva su database. Il capitolo 20A ci ha insegnato a specificare proprio questo confine.
Resta un limite da progettare prima di usare questo codice come ingresso pubblico: un file con milioni di righe vuote non supera mai MAX_TITOLI, e il metodo continua a leggere. La memoria delle righe resta contenuta, ma il tempo e il numero totale di caratteri letti no. Un servizio deve aggiungere un massimo complessivo di byte o caratteri, un massimo di righe anche vuote e, se la sorgente è una rete, un timeout al livello che governa la lettura. Quei limiti devono avere errori e test propri. Il nostro esempio prova due confini precisi; chiamarlo «importatore sicuro» senza dichiarare gli altri sarebbe un'affermazione falsa.
I due limiti non sostituiscono il controllo semantico. Potremmo rifiutare titoli duplicati, caratteri di controllo o stringhe che non corrispondono a una politica editoriale; oppure conservarli intenzionalmente. Prima si scrive la regola, poi si implementa e si testa. La validazione non è «ripulire tutto» finché un dato pericoloso sembra innocuo: una trasformazione silenziosa può cambiare il significato di un titolo. Nel programma normalizziamo gli spazi perché il caso di studio lo richiede; non eliminiamo arbitrariamente segni o accenti.
Un test che nasce dal nuovo rischio
Il programma ProvaImportazioneControllata verifica tre proprietà. Un input valido con una riga vuota produce due titoli; una riga di 81 unità è rifiutata; 101 righe non vuote sono rifiutate. rifiutato non si limita a catturare qualunque eccezione: controlla il messaggio atteso, così un NullPointerException accidentale non apparirebbe come il rifiuto progettato. La prova è un piccolo harness del JDK, eseguibile anche senza JUnit; in un progetto Maven sarebbe naturale trasferire gli stessi casi in test JUnit parametrizzati e con asserzioni appropriate.
import java.io.IOException;
import java.io.StringReader;
import java.util.List;

public final class ProvaImportazioneControllata {
    private ProvaImportazioneControllata() {
    }

    private static void rifiutato(String dati, String messaggio) {
        try {
            ImportazioneControllata.leggi(new StringReader(dati));
            throw new AssertionError("Input accettato: " + messaggio);
        } catch (IOException previsto) {
            if (!previsto.getMessage().equals(messaggio)) {
                throw new AssertionError("Errore diverso", previsto);
            }
        }
    }

    public static void main(String[] args) throws IOException {
        List<String> validi = ImportazioneControllata.leggi(
                new StringReader("  Java   moderno  \n\nReti\n"));
        if (!validi.equals(List.of("Java moderno", "Reti"))) {
            throw new AssertionError("Titoli inattesi: " + validi);
        }
        rifiutato("x".repeat(81), "Riga troppo lunga");
        rifiutato("x\n".repeat(101), "Troppi titoli");
        System.out.println("Input valido e due limiti verificati");
    }
}
Compilando dalla cartella esempi/C30 con javac --release 25 -Xlint:all -d build *.java, poi eseguendo java -cp build ProvaImportazioneControllata, otteniamo Input valido e due limiti verificati. Può apparire anche una riga di log informativa su stderr; formato, data e lingua dipendono dal provider di logging dell'ambiente, perciò la prova non confronta quei byte. Il test verifica invece il risultato e i due rifiuti, che fanno parte del contratto. Un'esecuzione positiva da sola non avrebbe esposto la crescita senza limite del codice precedente.
Concetto chiave – Sintassi, semantica e risorse. Un input può rispettare la forma e violare una regola del dominio; può rispettare entrambe ma costare troppo da elaborare; può essere valido in sé ma arrivare da un percorso che il chiamante non deve poter leggere. I controlli vanno posti al confine pertinente. Spostare un controllo da una fase all'altra senza capirne il costo può lasciare aperto proprio il problema che volevamo risolvere.
Rendere il codice più chiaro senza cambiare la promessa
L'esempio mostra anche una scelta di struttura: leggi governa il flusso, aggiungi contiene la regola della riga, main offre una dimostrazione. Una classe con un solo metodo di centinaia di righe che legge file, valida, salva, registra e stampa sarebbe più difficile da provare. Parliamo di coesione quando una parte del codice ha una responsabilità comprensibile; di accoppiamento quando una parte dipende da dettagli di un'altra. Non misuriamo qualità contando solo i metodi: dividere senza motivo può disperdere la logica quanto ammucchiarla.
Un refactoring modifica la struttura interna mantenendo il comportamento osservabile concordato. Per esempio, potremmo sostituire il StringBuilder con un componente LettoreRigheLimitate, purché i test sul limite, sulle righe vuote e sulla chiusura continuino a passare. Introdurre invece il limite di ottanta unità è una modifica funzionale: cambia gli input accettati e richiede una decisione di requisito, non può essere nascosta sotto il nome «pulizia del codice». Fare piccoli passi e conservare un commit leggibile per ciascuna decisione aiuta a distinguere l'errore introdotto dalla correzione intenzionale.
La duplicazione non è sempre il nemico principale. Due righe simili in contesti diversi possono rappresentare contratti diversi: una normalizzazione per i titoli del catalogo e una per i nomi di file non devono diventare per forza la stessa funzione generica. Cerchiamo prima quale conoscenza è davvero ripetuta. Nomi come MAX_RIGA, MAX_TITOLI, aggiungi e sorgente rendono visibile la scelta; un nome generico come processa costringerebbe il lettore a ricostruirla dal corpo del metodo. Il codice chiaro è uno strumento di sicurezza perché facilita la revisione, ma la leggibilità da sola non prova che ogni confine sia difeso.
Il compilatore e gli analizzatori: segnali, non verdetti
javac -Xlint:all abilita avvisi su varie categorie. Un warning non è automaticamente un difetto sfruttabile; è una richiesta di attenzione che va collegata a codice e rischio. Un warning di deprecazione può richiedere migrazione, mentre un warning generato da un esempio storico isolato può essere documentato. Una soppressione con @SuppressWarnings è una decisione locale: dovrebbe nominare la categoria pertinente e spiegare perché il caso è accettato. Sopprimere tutto in una configurazione globale rende più difficile notare un warning nuovo.
Un linter controlla convenzioni; un analizzatore di bug pattern cerca forme associate a difetti; uno strumento SAST, cioè di analisi statica della sicurezza, cerca flussi e usi pericolosi senza eseguire il programma. Checkstyle, PMD e SpotBugs sono esempi esterni al JDK, con scopi e regole differenti. Una regola può dare falsi positivi e un controllo pulito può lasciare falsi negativi. Per questo scegliamo un insieme gestibile, salviamo la configurazione con il codice e annotiamo le eccezioni motivate. Il gate non è «zero avvisi qualunque sia il costo»: è sapere quali avvisi rimangono, chi li ha valutati e quale decisione è stata presa.
L'analisi statica non vede tutto ciò che accade in esecuzione, come un plugin caricato da configurazione o una particolare combinazione di input e permessi. I test non vedono tutti i percorsi possibili. Una revisione umana può individuare un requisito sbagliato ma può non osservare una race condition rara. Queste prove si completano, ciascuna con un limite dichiarato. La tabella che accompagna una correzione dovrebbe dire quale proprietà viene difesa e quale prova la controlla, non solo elencare strumenti «passati».
Il confine del file e degli altri dati non fidati
Il nostro parser riceve caratteri da un Reader; non decide se un percorso è lecito. Se un servizio riceve un nome di file da un utente, Path.resolve e normalize costruiscono e semplificano percorsi, ma non dimostrano da soli che il file aperto resti dentro una cartella consentita. Segmenti .., percorsi assoluti, collegamenti simbolici e modifiche concorrenti del file system possono invalidare una verifica ingenua «il percorso normalizzato inizia con la cartella base». La strategia dipende dal requisito: spesso è meglio non accettare un percorso libero, ma un identificatore che il server traduce in un file già noto. Se il file system è modificabile da un avversario, controllo e apertura devono essere progettati insieme con API e permessi appropriati; il capitolo 25 aveva già distinto il nome dal file reale.
Lo stesso principio vale per un comando esterno. Costruire una stringa come "programma " + inputUtente e passarla a una shell mette l'input dentro la sintassi della shell. ProcessBuilder con programma e argomenti separati evita quella particolare interpretazione, ma non garantisce che l'argomento sia semanticamente sicuro per il programma chiamato. Per XML non fidato occorre configurare il parser rispetto a entità esterne e risorse accessibili, non assumere che «è XML» significhi «è solo testo». Per URL HTTP il client deve decidere host consentiti, redirect, timeout e dimensione delle risposte in base al contesto. La domanda comune è sempre: quale parte del dato controlla un altro soggetto e quale capacità le stiamo concedendo?
La serializzazione Java degli oggetti merita un'attenzione distinta. Un ObjectInputStream che legge byte non fidati può costruire un grafo di oggetti e attivare comportamenti durante la deserializzazione. Per nuove interfacce fra sistemi preferiamo formati con schema o parsing esplicito, insieme a limiti di dimensione e validazione. Se dobbiamo mantenere un formato serializzato esistente, ObjectInputFilter e la configurazione dei filtri possono ridurre le classi e le dimensioni accettate; non convertono un flusso sconosciuto in un input innocuo per definizione. Non mostriamo un esempio positivo di deserializzazione arbitraria che il lettore potrebbe copiare fuori dal suo contesto.
Nota bene – Segreti e log. Una password, una chiave API o un token non devono essere incorporati nel sorgente o stampati in un'eccezione per comodità. Spostarli in una variabile d'ambiente o in un archivio dedicato non elimina il bisogno di controllare accessi, rotazione e visibilità durante l'esecuzione. Anche un log apparentemente innocuo può includere percorsi personali, titoli riservati o corpi HTTP. Nel nostro esempio registriamo soltanto il numero di titoli importati, non il contenuto del file.
Riferimento essenziale – Novità di sicurezza nel JDK 25. La Key Derivation Function API è stabile e offre un contratto standard per derivare chiavi crittografiche da materiale segreto e altri dati. Risponde a un problema diverso dal limitare le righe dell'importatore o dal nascondere un token nel log: quando un'applicazione deve ottenere una chiave per un protocollo, algoritmo, parametri e gestione del segreto vanno scelti e verificati nel loro contesto. La stessa guida segnala l'API per codificare oggetti crittografici in formato PEM come preview. Qui le registriamo per collocare correttamente le novità di Java 25, senza trasformare un esempio di importazione di libri in una ricetta crittografica incompleta. Un uso reale richiederebbe un caso di sicurezza definito, i contratti delle API e prove specifiche.
Dipendenze: il progetto include anche ciò che non abbiamo scritto
Nel POM di C29 JUnit è una dipendenza di test, con una versione fissata. Anche una libreria usata solo per i test va aggiornata e acquisita da un'origine affidabile; una libreria di produzione incide inoltre sul programma consegnato. Leggere il grafo transitivo, registrare versioni e provenienza, verificare integrità degli artefatti e osservare avvisi di vulnerabilità note sono compiti ricorrenti. Una distinta base software, spesso chiamata SBOM, elenca componenti e versioni di una build; è utile per rispondere rapidamente a «questa versione vulnerabile è presente qui?». Non dimostra da sola che il componente sia stato usato in un percorso pericoloso né che il pacchetto sia sicuro.
Aggiornare una dipendenza è un cambiamento di programma, non una formalità. Si leggono note di versione e compatibilità, si esegue la build pulita, si verificano i casi di uso, si aggiorna la distinta e si conserva una decisione sul rischio residuo. Se una vulnerabilità segnalata riguarda codice irraggiungibile nel nostro caso, la valutazione va registrata con evidenze, non nascosta togliendo il controllo. Se l'artefatto arriva da un repository non previsto, prima di adottarlo occorre capire chi lo pubblica e come viene verificato. Il capitolo 29 ha dato la base ripetibile per fare queste domande a un insieme preciso di file.
Registrare eventi utili senza confondere log e risultato
System.getLogger restituisce un logger dell'API di piattaforma. L'implementazione effettiva può inoltrare i messaggi a un backend diverso secondo l'ambiente; non ci affidiamo alla forma testuale del messaggio come interfaccia del programma. In ImportazioneControllata, LOG.log(Level.INFO, "Importati {0} titoli", titoli.size()) registra un fatto utile a fine importazione senza ripetere nel log i titoli. Un errore di input potrebbe essere registrato da un livello superiore con identificatore della richiesta, categoria e causa, evitando di pubblicare tutto il contenuto rifiutato. Se ogni metodo registra e rilancia lo stesso errore, un singolo fallimento può generare molte righe identiche: prima decidiamo chi possiede la responsabilità del log.
I livelli aiutano a distinguere rumore ordinario, eventi informativi, problemi recuperabili e fallimenti. Il contesto di una richiesta, per esempio un identificatore opaco, aiuta a collegare più operazioni senza scrivere dati personali. Un log strutturato rende più facile filtrare campi rispetto a frasi libere, ma schema, retention e accessi ai log sono decisioni del sistema, non di System.Logger da sola. In una prova automatica confrontiamo il comportamento dell'operazione, non la data o la lingua scelta dal backend del logger. Quando il log è esso stesso un requisito di audit, lo testiamo con un contratto dedicato e un provider controllato.
Dal messaggio al comportamento della JVM
Supponiamo che l'importazione sia corretta ma lenta. Il log «Importati 2 titoli» non dice dove sia passato il tempo. Un thread dump mostra dove si trovano i thread in un istante; jcmd <pid> Thread.print è uno dei comandi diagnostici che la JVM può offrire. Un singolo dump può trovare un'attesa evidente, ma non racconta da solo quanto spesso sia accaduta. Java Flight Recorder, o JFR, raccoglie eventi nel tempo. Può mostrare attività della JVM, attese e eventi applicativi che definiamo noi. La diagnostica ha un costo e può contenere dati sensibili: in produzione si scelgono impostazioni, durata e accessi secondo il problema.
Il programma DiagnosiImportazione definisce un evento esempio.catalogo.Importazione con il numero di titoli. Avvia una registrazione JFR, abilita l'evento senza soglia minima di durata per questo esempio, importa tre volte lo stesso piccolo testo e salva il file indicato sulla riga di comando. evento.begin() segna l'inizio della misura; commit() conclude e registra l'evento. Non inseriamo nel JFR i titoli, soltanto il loro numero. Il programma non è un benchmark: le tre durate dipendono da avvio, JIT, sistema operativo e carico.
import java.io.StringReader;
import java.nio.file.Path;
import java.time.Duration;
import jdk.jfr.Event;
import jdk.jfr.Label;
import jdk.jfr.Name;
import jdk.jfr.Recording;

public final class DiagnosiImportazione {
    @Name("esempio.catalogo.Importazione")
    @Label("Importazione del catalogo")
    static class EventoImportazione extends Event {
        @Label("Titoli")
        int titoli;
    }

    private DiagnosiImportazione() {
    }

    public static void main(String[] args) throws Exception {
        if (args.length != 1) {
            throw new IllegalArgumentException("Uso: DiagnosiImportazione <file.jfr>");
        }
        try (Recording registrazione = new Recording()) {
            registrazione.enable(EventoImportazione.class)
                    .withThreshold(Duration.ZERO);
            registrazione.start();
            for (int i = 0; i < 3; i++) {
                EventoImportazione evento = new EventoImportazione();
                evento.begin();
                evento.titoli = ImportazioneControllata.leggi(
                        new StringReader("Java moderno\nReti\n")).size();
                evento.commit();
            }
            registrazione.stop();
            registrazione.dump(Path.of(args[0]));
        }
        System.out.println("Registrate 3 importazioni");
    }
}
Dalla cartella esempi/C30, dopo la compilazione già descritta, possiamo usare java -cp build DiagnosiImportazione build/catalogo.jfr e poi jfr print --events esempio.catalogo.Importazione build/catalogo.jfr. Nella registrazione verificata sono presenti tre eventi con titoli = 2. La figura 30.3 è una lettura annotata di quel risultato: cerchiamo il nome dell'evento, il campo di dominio, il thread e le durate variabili. Non usiamo i valori temporali della figura come soglia per un altro computer.
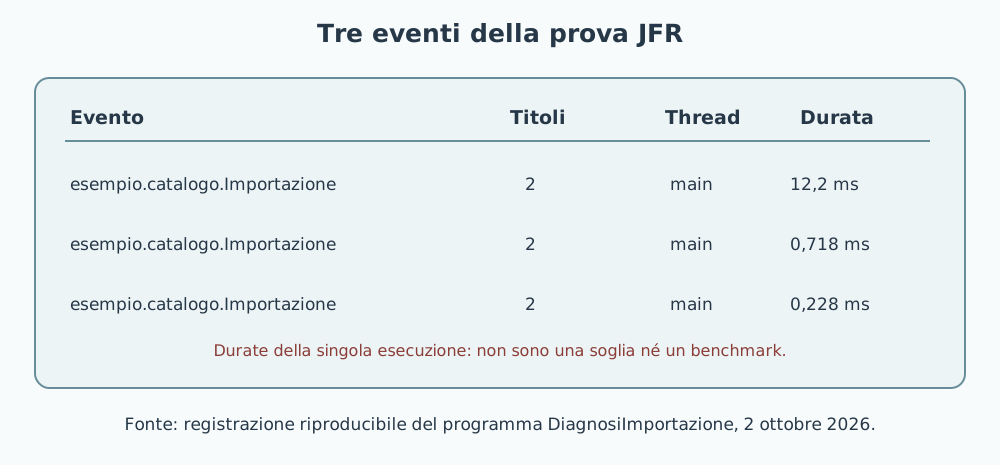
esempio.catalogo.Importazione registrano due titoli ciascuno; le durate osservate sono dati della singola prova, non promesse di prestazione.jcmd e JFR rispondono a domande diverse. Se il processo è bloccato adesso, un dump può indicare l'attesa corrente. Se la lentezza appare a intervalli, una registrazione può mostrare distribuzione degli eventi, allocazioni e attese nel periodo osservato, a seconda delle impostazioni. Se manca il nostro evento, controlliamo che fosse abilitato, che la registrazione coprisse il momento giusto e che il filtro --events indichi il nome corretto. «Non vedo eventi» non equivale immediatamente a «il codice non è stato eseguito». Il modulo jdk.jfr fa parte del JDK usato nella prova; un runtime ridotto creato con jlink deve includerlo se l'applicazione usa direttamente questa API.
Misurare una prestazione significa dichiarare un esperimento
Il capitolo 20A aveva messo in guardia dal concludere che LongAdder sia sempre più veloce di AtomicLong. Lo stesso vale per il parser. Cronometrare una sola chiamata a ImportazioneControllata.leggi con System.nanoTime() mescola avvio della JVM, compilazione JIT, lettura dell'input e rumore del sistema. Un microbenchmark serio richiede warm-up, più misure, controllo dei dati consumati e un ambiente dichiarato. JMH, lo strumento esterno del progetto OpenJDK per i benchmark sulla JVM, aiuta a costruire quell'esperimento; non trasforma un confronto mal posto in una risposta utile. Se il problema reale è il tempo per importare un archivio di cento megabyte su disco, occorre anche una prova di carico rappresentativa, non solo la velocità di una funzione su due righe in memoria.
Una prestazione ha più dimensioni: latenza di una richiesta, throughput di molte richieste, memoria, CPU, code e pause. Ottimizzare la media mentre una piccola quota di utenti attende troppo può peggiorare l'esperienza. Prima di cambiare codice, descriviamo carico e misura, riproduciamo il collo di bottiglia, confrontiamo una modifica alla volta e conserviamo i risultati con macchina, JDK e configurazione. Una registrazione JFR può suggerire dove indagare; un benchmark o un test di carico può verificare se la modifica aiuta nel contesto scelto. Nessuno dei due decide al posto nostro quale proprietà conta per il lettore o per l'utente.
Un incidente diventa conoscenza quando lasciamo una prova
Immaginiamo che un'applicazione in produzione termini durante l'importazione di un file molto lungo. Prima di cambiare una riga, raccogliamo condizioni: versione dell'artefatto, JDK, dimensione e formato dell'input, messaggio di errore, log pertinenti, eventuale registrazione JFR e limiti della macchina. Riduciamo il caso a un file che riproduce il fallimento senza conservare dati riservati. Se il problema è la riga illimitata, scriviamo una prova che la supera e osserviamo il difetto nella versione precedente; poi introduciamo il limite, eseguiamo di nuovo e controlliamo che gli input validi continuino a funzionare. La modifica entra in una build che un collega può ripetere grazie al capitolo 29.
Non ogni incidente nasce da una sola riga difettosa. Un servizio remoto può aver rallentato, una dipendenza può aver cambiato comportamento, un file system può aver esaurito spazio. Il rapporto finale distingue causa osservata, ipotesi escluse, correzione, prova di regressione e rischio residuo. Se la causa non è ancora dimostrata, la scriviamo come ipotesi invece di trasformarla in certezza per chiudere il ticket. Questa disciplina rispetta chi dovrà mantenere il programma dopo di noi.
Le attività C29–C30 chiedono di riconoscere in quale confine nasce un difetto, aggiungere un test che lo renda visibile e scegliere una diagnosi adeguata. Il trasferimento finale cambia ancora il problema: al posto di un file arrivano righe da una risposta HTTP e il catalogo deve registrare su database soltanto l'insieme completo e valido. I limiti del parser restano utili, ma non bastano. Occorre definire timeout e dimensione della risposta, errore di rete, transazione dell'archivio e comportamento in caso di retry. Il lettore ha costruito il modello quando sa estendere le domande al nuovo confine senza credere che una build verde o una classe chiamata «sicura» risolva tutto.
Domanda finale – Quale prova manca? Per ogni modifica chiediamo: quale problema concreto affronta, quale invariante o rischio governa, come vediamo che funziona e quale caso vicino la farebbe fallire? Il buon codice non è un trofeo statico. È un insieme di decisioni che altri possono leggere, verificare e migliorare senza dover indovinare perché furono prese.
Riferimenti essenziali
Riferimento essenziale – Contratti e diagnosi. La specifica di
System.Loggerchiarisce l'API di logging; la guida Java 25 ai filtri della serializzazione e la specifica diObjectInputFilterdescrivono il perimetro difensivo per codice legacy. Le specifiche dijcmd,jfr,EventeRecordingsostengono la prova diagnostica. Il progetto OpenJDK JMH documenta lo strumento per i benchmark. Nessuna di queste fonti fornisce da sola una politica di sicurezza o una soglia di prestazione valida per ogni applicazione: tali decisioni dipendono dal sistema e dalle prove raccolte.