Quando un programma svolge più lavori
Un'applicazione può dover attendere una risposta dalla rete mentre continua a servire altre richieste, leggere dati mentre aggiorna una vista o distribuire una computazione su più unità di elaborazione. Un programma concorrente sembra trovarsi logicamente in più punti nello stesso periodo. Questa immagine aiuta a iniziare, purché non ci faccia immaginare un ordine unico delle istruzioni. Le attività concorrenti avanzano secondo tempi che il nostro programma non controlla del tutto. Su più core possono eseguire davvero nello stesso istante; su un solo core possono alternarsi abbastanza rapidamente da fare progressi nello stesso intervallo di tempo.
Un processo è un’istanza di programma con proprie risorse gestite dal sistema operativo. I thread di un processo condividono parte dello spazio di memoria e possono accedere agli stessi oggetti Java. Passare loro un riferimento permette di raggiungere lo stesso dato, ma non basta a comunicare correttamente: se un thread lo modifica e un altro lo legge, dobbiamo stabilire quando la modifica può essere osservata. La memoria condivisa non richiede di trasferire ogni valore tramite un messaggio fra processi, ma la comunicazione conserva costi e regole di sincronizzazione. Due incrementi sullo stesso contatore, per esempio, possono perdere un aggiornamento se non sono coordinati; lo vedremo nel programma del capitolo. Scegliere fra più processi e più thread richiede anche di valutare isolamento, affidabilità e distribuzione, oltre al costo di avvio e al lavoro necessario per condividere i dati.
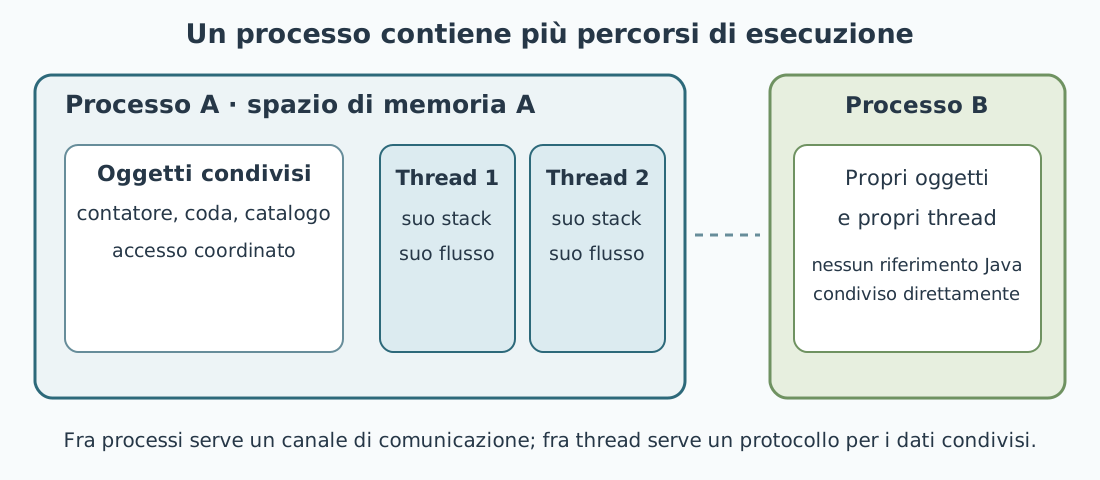
Definizione – Concorrenza e parallelismo. Concorrenza significa che più attività sono in corso e possono progredire in un periodo sovrapposto. Parallelismo significa che almeno due operazioni vengono eseguite materialmente nello stesso istante su risorse distinte. Un programma concorrente può essere eseguito senza parallelismo; un programma parallelo è necessariamente concorrente. Questa distinzione impedisce di promettere un'accelerazione solo perché abbiamo creato due thread.

I thread offrono vantaggi, ma comportano anche costi: una risposta può rimanere pronta mentre un'altra operazione attende; il lavoro su dati indipendenti può sfruttare più core; risorse condivise possono essere riutilizzate. Ma ogni accesso condiviso può introdurre race condition, attese, deadlock o risultati difficili da riprodurre. Aumentare il numero dei thread non rende automaticamente il programma più veloce. Se il collo di bottiglia è una singola risorsa seriale, aggiungere lavoro concorrente può peggiorare il tempo totale.
Dalla richiesta di avvio alla fine
L'oggetto Thread rappresenta un thread di esecuzione. Un Runnable descrive il lavoro da svolgere e non restituisce un valore. Quando chiamiamo start(), chiediamo l'avvio di un nuovo thread che eseguirà run(). Chiamare direttamente run() esegue invece il metodo nel thread corrente: è una normale chiamata di metodo. Questa differenza è il primo esperimento da compiere, stampando Thread.currentThread().getName() nei due casi. Nel codice moderno spesso è più chiaro separare il lavoro dalla gestione del thread, usando una lambda Runnable anziché estendere Thread, a meno che la sottoclasse rappresenti davvero un comportamento specifico.

run() chiamato direttamente resta nel chiamante; start() richiede un nuovo thread che eseguirà lo stesso lavoro.L'API espone gli stati NEW, RUNNABLE, BLOCKED, WAITING, TIMED_WAITING e TERMINATED. NEW descrive un oggetto non avviato; TERMINATED un'esecuzione conclusa. BLOCKED indica attesa per acquisire un monitor; WAITING e TIMED_WAITING coprono forme di attesa senza o con limite temporale. RUNNABLE include sia il thread eseguito dal processore sia quello pronto a essere scelto. A volte si chiama «running» il thread che sta usando la CPU, ma RUNNING non compare nell'enumerazione Thread.State: teniamo separato lo stato pubblico dalla descrizione intuitiva dello scheduler.
Il programma AvvioEJoin rende visibile la distinzione fra oggetto e attività. Prima di start, lo stato è NEW. Una chiamata diretta a lavoratore.run() stampa esegue: main, perché il lavoro viene svolto dal thread principale; lo stato dell'oggetto lavoratore rimane NEW. Dopo start, il Runnable stampa esegue: lavoratore. main chiama join e solo dopo osserva TERMINATED. Il programma non si affida all'ordine casuale fra le due stampe: la prima avviene prima di start; la seconda deve terminare prima che join ritorni. Un thread non può essere avviato due volte con start: dopo la prima partenza, tentare di ripartire con lo stesso oggetto produce IllegalThreadStateException. Per un nuovo lavoro si crea un nuovo Thread o si affida l'attività a un esecutore.
NEW -- start() --> RUNNABLE -- run() termina --> TERMINATED
                      |
                      +-- attende monitor --> BLOCKED --> RUNNABLE
                      +-- attende evento ----> WAITING --> RUNNABLE
                      +-- attende tempo -----> TIMED_WAITING --> RUNNABLE
Schema testuale degli stati. Le frecce indicano casi tipici, non un calendario prevedibile. Uno stesso thread può tornare più volte a RUNNABLE prima di terminare.

Thread.Il metodo join() permette a un thread di attendere la fine di un altro. Se il thread corrente viene interrotto mentre attende, join() lancia InterruptedException. sleep sospende il thread corrente per almeno l'intervallo richiesto nelle condizioni previste dall'API, ma non assicura che riprenda in un istante esatto. yield() è un suggerimento allo scheduler, che può ignorarlo. Le priorità dei thread di piattaforma sono anch'esse suggerimenti dipendenti dall'implementazione e dal sistema operativo: non sono uno strumento per ottenere un ordine corretto di output. Se due thread stampano senza fine «priorità alta» e «priorità bassa», il risultato fotograferebbe una sola esecuzione e il programma potrebbe consumare risorse senza terminare; non dimostrerebbe una garanzia del linguaggio.
Che cosa possiamo e non possiamo dedurre dal tempo
Se main avvia un lavoratore e chiama join(4000), l'attesa può terminare perché il lavoratore è finito, perché è trascorso il tempo indicato o perché main è stato interrotto, nel qual caso riceve un'eccezione. Dopo una join con limite temporale occorre dunque controllare se il lavoro è ancora vivo prima di dichiararlo completato. La differenza fra join senza limite e join con timeout riguarda la possibilità di tornare prima della conclusione del lavoratore, non l'ordine esatto delle stampe in un'esecuzione. Un timeout può aiutare a evitare un'attesa indefinita, ma non annulla automaticamente il lavoro rimasto attivo.
sleep è utile per simulare attese in un esempio, ma non è un meccanismo di coordinamento fra thread. Scrivere «attendo cento millisecondi e quindi il dato sarà pronto» lega la correttezza alla velocità di una macchina e al carico del sistema. Occorre invece attendere una condizione con strumenti appropriati: join per la conclusione di un thread, una coda bloccante per la disponibilità di un elemento, un Future per il risultato di un'attività. La specifica chiarisce anche che né sleep né yield introducono da soli le relazioni di sincronizzazione richieste per rendere visibile una scrittura condivisa.
La priorità ha un problema analogo. setPriority accetta valori nell'intervallo definito da MIN_PRIORITY, NORM_PRIORITY e MAX_PRIORITY per i thread ai quali si applica, ma il modo in cui influisce sulla pianificazione dipende dalla piattaforma. Un test che passa solo se il thread ad alta priorità stampa per primo è sbagliato: sta misurando un comportamento che l'API non garantisce. Possiamo mostrare la lettura e l'impostazione della priorità come proprietà del thread di piattaforma, senza dedurne una regola di precedenza semantica.
La memoria condivisa e l'operazione ++
Immaginiamo un contatore int valore su cui due thread eseguono valore++ diecimila volte ciascuno. Il risultato atteso sul piano aritmetico è ventimila, ma l'operazione ++ sul campo non è un'azione indivisibile. Occorre leggere il valore, sommare uno e scrivere il nuovo valore. I due thread possono leggere lo stesso numero prima di scrivere, perdendo un incremento. Il problema non si risolve aggiungendo una pausa casuale o scegliendo una priorità diversa: l'ordine casuale resta possibile e il problema di visibilità fra thread resta aperto.
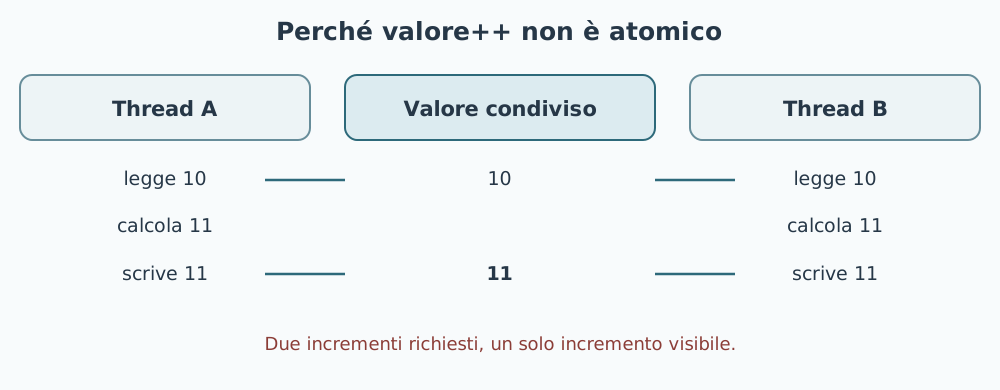
Nel programma ContatoreProtetto, incrementa() e leggi() sono synchronized. I due metodi usano il monitor dell'istanza contatore. Soltanto un thread alla volta può eseguire una sezione protetta da quel medesimo monitor; l'uscita e la successiva acquisizione stabiliscono anche una relazione di visibilità secondo il Java Memory Model. Dopo aver avviato i due thread, main chiama join() su entrambi e poi legge il valore. L'output verificato è 20000. Senza le condizioni di sincronizzazione non potremmo usare quella cifra come prova di correttezza, anche se qualche esecuzione fortunata la stampasse.

Un metodo di istanza synchronized usa il monitor di this. Un metodo static synchronized usa invece il monitor dell'oggetto Class che rappresenta la classe: non blocca automaticamente i monitor delle singole istanze. Un blocco synchronized(lock) permette di scegliere un oggetto dedicato e limitare la sezione critica alle sole istruzioni che ne hanno bisogno. Il lock deve essere condiviso dai thread che proteggono la stessa invariante. Due blocchi che usano oggetti diversi non si escludono, anche se nel sorgente entrambi contengono la parola synchronized.
private final Object lock = new Object();
private int valore;

void incrementa() {
    synchronized (lock) {
        valore++;
    }
}
Qui il campo lock è privato e finale: il codice esterno non può scegliere di acquisirlo e interferire con il protocollo interno. Il carattere final impedisce di sostituire il riferimento, non trasforma automaticamente in immutabili gli oggetti a cui un riferimento può puntare. Il valore protetto resta mutabile e deve essere letto con la stessa disciplina. Se aggiungessimo int leggi() { return valore; } senza sincronizzazione o altro meccanismo appropriato, avremmo rotto la regola di visibilità del contatore pur avendo protetto le scritture.
Quando due lock si aspettano a vicenda
Un deadlock può nascere se il thread A possiede il lock primo e aspetta secondo, mentre il thread B possiede secondo e aspetta primo. Nessuno può proseguire fino a rilasciare il lock che l'altro richiede. Il sistema non garantisce che il programma riconosca e risolva automaticamente questa situazione. Una regola semplice è acquisire più lock sempre nello stesso ordine documentato, oppure ridurre il numero di lock necessari. Il problema non è che i thread siano «lenti»: è che le condizioni logiche per avanzare sono diventate circolari.
Thread A: possiede primo  → attende secondo
Thread B: possiede secondo → attende primo
Questo schema descrive una situazione da evitare, non un esempio da eseguire nel percorso normale: due thread bloccati per sempre renderebbero la prova poco utile. Possiamo studiarla con una traccia o in un test isolato con un limite di tempo e diagnostica dei thread. In una revisione del codice si cercano coppie di sezioni che acquisiscono gli stessi lock in ordine opposto. Anche chiamare codice sconosciuto mentre si tiene un lock è rischioso, perché quel codice potrebbe cercare un altro lock o impiegare molto tempo.
Approfondimento – Tre proprietà diverse. Mutua esclusione significa che due sezioni protette dallo stesso lock non si eseguono contemporaneamente. Atomicità significa che un'operazione appare indivisibile rispetto agli altri thread. Visibilità significa che una scrittura eseguita da un thread può essere osservata correttamente dall'altro.
volatilefornisce particolari garanzie di visibilità e ordine, ma non rende atomicovalore++.synchronizedsu un monitor comune può offrire sia esclusione sia le relazioni di memoria necessarie. Per un contatore indipendente esistono anche tipi atomici, comeAtomicInteger; la scelta dipende dalle invarianti da proteggere.
La parola invariante indica una condizione che deve restare vera nei punti osservabili del programma. Se una coppia di campi saldo e totale deve essere aggiornata insieme, proteggere con un'operazione atomica un solo campo non basta. Il lock deve coprire il cambiamento coerente di entrambi. Questo è il motivo per cui la sincronizzazione non può essere aggiunta alla cieca: prima si identifica quale stato è condiviso e quale proprietà deve mantenere.
Un conto corrente letto da due persone
Un conto corrente fa vedere quanto una race condition possa essere più seria di un numero del contatore sbagliato. Supponiamo che il saldo sia 500 euro e che due richieste di prelievo da 400 euro arrivino quasi insieme. Ogni richiesta potrebbe leggere il saldo, verificarne la sufficienza e decidere di procedere. Se entrambe leggono 500 prima che una scriva il nuovo saldo, entrambe ritengono consentito il prelievo. A seconda della forma del codice si può registrare due volte un'uscita pur conservando un saldo incoerente, o perdere una delle modifiche. Non basta rendere atomica la sola sottrazione: il controllo «saldo sufficiente» e l'aggiornamento devono costituire un'unica operazione dal punto di vista degli altri thread.
synchronized (lock) {
    if (saldo < importo) {
        return false;
    }
    saldo -= importo;
    return true;
}
Questo frammento assume un lock condiviso e privato e un importo già validato come positivo. Il suo punto centrale è il confine della sezione critica, non una soluzione completa per un conto bancario: transazioni su database, persistenza e più processi richiedono garanzie ulteriori. Se il saldo è memorizzato su un server, un monitor Java di un singolo processo non coordina altre istanze dell'applicazione. Un libro di base deve mostrare il meccanismo senza estendere la promessa oltre il confine in cui vale.
Definizione – Sezione critica. È la parte del programma che accede a stato condiviso e deve rispettare una regola comune. L'esclusione ha valore solo se tutti i percorsi che modificano o leggono quello stato in modo rilevante usano lo stesso protocollo. Una sezione critica troppo ampia aumenta l'attesa; una troppo stretta lascia scoperte parti dell'invariante. La sua dimensione si decide dalla proprietà da mantenere, non dal numero di righe che sembra comodo racchiudere fra parentesi.
Il ruolo preciso di volatile
Un campo volatile permette a una scrittura e a una lettura successive del medesimo campo di partecipare alla relazione happens-before descritta dal Java Memory Model. In un segnale semplice, un thread legge fermati finché un altro lo pone a true. Il programma SegnaleVolatile usa questa forma e stampa fermato dopo la richiesta. Non usa sleep per rendere visibile il cambiamento: il valore volatile è il mezzo di comunicazione. Thread.onSpinWait() è solo un suggerimento di ottimizzazione del ciclo di attesa attiva; non sostituisce la dichiarazione volatile e non è adatto quando il lavoro potrebbe attendere a lungo.

volatile, senza imporre una particolare architettura delle cache.Confrontiamo il ciclo con un booleano ordinario e poi con volatile. Il punto è che il compilatore e la CPU possono trattare le letture non sincronizzate in modi che sorprendono chi immagina una sola memoria immediatamente condivisa. Non promettiamo però che la versione difettosa si blocchi in ogni esecuzione o su ogni macchina. La prova empirica di una sola corsa non definisce la semantica: è la relazione di memoria stabilita dalla specifica a consentirci di ragionare sulla versione corretta.
volatile non protegge un'operazione composta. Con volatile int valore, la lettura di valore, il calcolo di +1 e la scrittura sono ancora passi separati. Due thread possono leggere lo stesso vecchio valore e scrivere lo stesso nuovo valore. Se l'unica invariante è un contatore indipendente, AtomicInteger offre incrementAndGet(), che esprime un incremento atomico. Il programma avvia due thread, ne attende la conclusione e stampa 20000. È una soluzione diversa dal monitor di ContatoreProtetto: non rende automaticamente atomiche altre modifiche che abbiamo dimenticato di includere.
Approfondimento –
happens-beforenon è il cronometro. La relazione indica quali effetti di memoria devono risultare visibili e in quale ordine logico per un programma correttamente sincronizzato. Non significa semplicemente che un'istruzione è stata eseguita pochi millisecondi prima di un'altra.Thread.startstabilisce una relazione dalle azioni precedenti all'avvio alle azioni del nuovo thread; la conclusione osservata conjoinstabilisce una relazione dalle azioni del lavoratore a quelle successive del chiamante. Questo spiega perchémain, dopojoin, può leggere il risultato finale di un lavoro svolto dal thread terminato. Per accessi condivisi mentre entrambi lavorano, occorre comunque un protocollo adatto.
Interruzione: una richiesta cooperativa
interrupt() segnala a un thread che dovrebbe interrompere il lavoro o uscire da un'attesa. Non equivale a terminare forzatamente il thread in un punto arbitrario. Se il thread è in una chiamata bloccante interrompibile, come sleep, join o BlockingQueue.take, può ricevere InterruptedException. In quel momento il segnale di interruzione viene normalmente cancellato dalla chiamata che lancia l'eccezione. Se il livello corrente non sa concludere l'operazione e deve restituire il controllo, può ripristinare il segnale con Thread.currentThread().interrupt() e terminare il proprio ciclo, come fanno gli esempi di questo capitolo.
Consideriamo un blocco catch (InterruptedException e) {} vuoto. Un blocco vuoto può lasciare il thread al lavoro dopo che un altro componente ha chiesto la chiusura. In un piccolo programma dimostrativo potrebbe passare inosservato; in un servizio con risorse reali rende la terminazione incerta. Se il metodo può dichiarare throws InterruptedException, spesso è meglio lasciare propagare l'eccezione. Se non può, documentiamo come la richiesta viene rispettata. Non esiste una risposta unica per ogni applicazione, ma ignorare il segnale per distrazione non è una strategia.
Nota – Interruzione e stato.
isInterrupted()legge il segnale senza azzerarlo.Thread.interrupted()è statico e consulta il thread corrente azzerandone il segnale. La differenza conta nei cicli che aspettano una richiesta di arresto. Non usiamo i due metodi come sinonimi; prima decidiamo se il codice deve soltanto osservare l'interruzione o anche consumarne l'indicazione.
Produttore e consumatore, dal difetto alla soluzione
Il caso produttore-consumatore merita un percorso graduale, perché ogni soluzione fa emergere un nuovo requisito. Un produttore genera valori; un consumatore li usa. Se il consumatore legge un campo prima che il produttore inserisca il prossimo valore, può ottenere un dato non pronto o riutilizzare il precedente. Una lista condivisa senza protocollo non risolve la questione. Anche con metodi synchronized, un controllo if (lista.isEmpty()) wait() è insufficiente: dopo il risveglio la condizione va ricontrollata in un while, perché un altro consumatore può aver preso l'elemento oppure il risveglio può non corrispondere alla disponibilità attesa.
wait() richiede il monitor dell'oggetto su cui è chiamato; rilascia quel monitor durante l'attesa e lo riacquisisce prima di proseguire. notifyAll() risveglia i thread in attesa sullo stesso monitor, ma non consegna loro immediatamente la risorsa: devono competere per il monitor e verificare di nuovo la condizione. Con due consumatori può emergere un errore: occorre osservare che la condizione di attesa non è un permesso permanente a rimuovere un elemento. Un'implementazione manuale corretta richiede un protocollo completo per disponibilità, chiusura e interruzione.
La libreria standard fornisce BlockingQueue<E> per questo caso. Una coda limitata può bloccare put quando è piena e take quando è vuota. Nel programma ProduttoreConsumatore usiamo ArrayBlockingQueue<Integer> con capacità due. Il produttore inserisce i numeri da zero a quattro; il consumatore ne legge uno alla volta. Dopo i dati, il produttore inserisce la sentinella -1, che indica la fine. La sentinella è sicura qui perché i dati validi sono solo da zero a quattro. In un sistema reale occorre verificare che un valore speciale non possa confondersi con un dato e che la terminazione funzioni anche quando il produttore fallisce.
Costruire il protocollo a mano per capirlo
Prima di usare la coda pronta, costruiamo un deposito a un solo posto e correggiamo passo dopo passo la sua sincronizzazione. Nel programma DepositoConAttesa il campo prodotto vale null quando il posto è vuoto. inserisci attende con while (prodotto != null) fino a quando il consumatore ha prelevato il valore precedente; preleva attende con while (prodotto == null) fino a quando arriva un valore. Entrambi i metodi sono synchronized sull'istanza del deposito. Cambiata la condizione, chiamano notifyAll() perché i thread che aspettano possano ricontrollarla.
La forma while non è una preferenza di stile. La specifica permette risvegli senza una corrispondente notify, e un altro thread può cambiare la condizione prima che il thread risvegliato riacquisti il monitor. Con if, il controllo avviene una sola volta e il metodo può proseguire quando il deposito è ancora vuoto o ancora pieno. Con due consumatori, questo difetto può manifestarsi anche quando una prova con un solo consumatore sembra funzionare. Nel nostro primo programma manuale c'è un solo consumatore, così il lettore può isolare il protocollo di un posto prima di ragionare sulla competizione fra molti consumatori.

wait rilascia il monitor; dopo la notifica il thread riacquisisce il monitor e ricontrolla la condizione.public synchronized int preleva() throws InterruptedException {
while (prodotto == null) {
wait();
}
int numero = prodotto;
prodotto = null;
notifyAll();
return numero;
}
La chiamata a wait() appartiene all'oggetto deposito e avviene mentre il thread ne possiede il monitor. Durante l'attesa quel monitor viene rilasciato: altrimenti il produttore non potrebbe entrare in inserisci e la condizione non cambierebbe mai. Prima del ritorno da wait, il thread riacquisisce il monitor; solo allora controlla di nuovo il while. notifyAll non trasferisce direttamente il valore al consumatore e non fa uscire subito dal metodo chi lo chiama. È una notifica a chi attende sul medesimo oggetto.
Il valore -1 conclude il flusso, come nella versione con BlockingQueue. La stampa dei valori da zero a quattro è deterministica perché un solo produttore li inserisce nell'ordine previsto e un solo consumatore li preleva nell'ordine del deposito. L'esempio mostra il funzionamento normale, ma non ancora ogni caso di produzione. Se il produttore viene interrotto prima di inserire la sentinella, il consumatore potrebbe attendere per sempre. Un servizio robusto richiede una procedura di chiusura anche per gli errori; una coda bloccante semplifica trasferimento e capacità, ma da sola non definisce la politica di chiusura dell'applicazione.
Le quattro forme di inserimento e prelievo
L'interfaccia BlockingQueue offre più modi di reagire a pieno e vuoto. add può lanciare un'eccezione se non c'è spazio; offer restituisce false; put aspetta. La forma di offer con timeout aspetta al più il tempo dichiarato e restituisce un booleano. Per leggere, remove può lanciare un'eccezione sul vuoto, poll restituisce null, take aspetta; esiste anche poll con timeout. element e peek osservano l'elemento in testa senza rimuoverlo, con differenze analoghe sul caso vuoto. Il chiamante sceglie in base al contratto: «non c'è spazio» può essere un errore, una risposta ordinaria o una condizione da attendere.
| Operazione | Fallimento immediato con eccezione | Risposta immediata speciale | Attesa | Attesa con timeout |
|---|---|---|---|---|
| Inserire | add(e) |
offer(e) → false |
put(e) |
offer(e, tempo, unità) |
| Prelevare | remove() |
poll() → null |
take() |
poll(tempo, unità) |
| Osservare la testa | element() |
peek() → null |
non prevista | non prevista |
Il null di poll non può essere scambiato con un elemento valido, perché BlockingQueue non permette di inserire null. Questo dettaglio fa parte del contratto e rende interpretabile la risposta speciale. Una coda limitata come ArrayBlockingQueue applica una capacità definita; una coda senza limite fisso può accettare elementi finché ci sono risorse disponibili, quindi «senza limite» non significa memoria infinita. La capacità è una decisione di progetto: limita la pressione del produttore sul consumatore e rende osservabile un rallentamento invece di far crescere indefinitamente la memoria occupata.

L'output contiene sempre i cinque valori consumati in ordine, perché una singola coda FIFO alimenta un solo consumatore, ma non possiamo dedurre da quelle righe quando esattamente i due thread hanno ottenuto CPU. Con più consumatori, una stampa che alterna produttore e lavoratori rappresenta una possibile intercalazione, non l'unico «output atteso». Con più consumatori il reparto dei valori fra i nomi dei thread non è deterministico; si verificano invece proprietà come «ogni valore valido è consumato una volta» e «nessun consumatore resta bloccato dopo la chiusura». Se ci fossero due consumatori, una sola sentinella non basterebbe a concluderli entrambi.
Thread di piattaforma e thread virtuali
Fin qui abbiamo visto due forme di avvio: il contatore crea thread di piattaforma con Thread.ofPlatform(), mentre il produttore-consumatore usa Thread.ofVirtual(). Entrambi i programmi attendono la conclusione con join. Le chiamate a BlockingQueue.put e take mantengono lo stesso significato; per capire perché scegliere una forma anziché l'altra dobbiamo guardare al lavoro che il thread svolge e al tempo che trascorre in attesa.
Approfondimento – Attività e durata. Se un server riceve molte richieste indipendenti che attendono servizi esterni, un thread virtuale per richiesta può essere una scelta leggibile. Se invece dobbiamo moltiplicare grandi matrici, il lavoro utile è limitato dai core disponibili e dalla memoria; creare un numero enorme di thread non produce core aggiuntivi. Per scegliere bene bisogna misurare il tipo di attesa, la durata delle attività e la quantità di stato condiviso.
Perché è servito un altro tipo di thread
Immagina un servizio che riceve richieste di prestito. Per ognuna controlla il catalogo, interroga un archivio remoto e infine prepara una risposta. Il codice più naturale segue quest'ordine: chiama il catalogo, aspetta la risposta, chiama l'archivio, aspetta ancora e compone il risultato. Durante le due attese non sta calcolando: la CPU potrebbe occuparsi di un'altra richiesta. Con un thread di piattaforma per richiesta, però, ogni attesa trattiene anche un thread del sistema operativo per tutta la durata della richiesta. Quando le richieste simultanee diventano numerose, quel costo limita la capacità del servizio prima ancora che la CPU sia piena.
Un pool di thread riutilizza i thread e risparmia il costo di crearli ripetutamente, ma non risolve il vincolo: se il pool contiene cento lavoratori e cento richieste sono ferme ad aspettare risposte esterne, la richiesta successiva resta in coda. Un'altra strada è spezzare ogni richiesta in callback o CompletableFuture, così i lavoratori sono liberi mentre l'I/O è in corso. Il prezzo è che il percorso logico di una richiesta si distribuisce fra più funzioni e diventa più difficile seguire valori, errori e cancellazione. I thread virtuali sono stati introdotti per conservare il modello leggibile «un thread per richiesta» anche quando molte richieste aspettano contemporaneamente. Sono diventati una funzionalità stabile in Java 21; in questa edizione li usiamo con Java 25. La motivazione del progetto e la guida Java 25 descrivono questo obiettivo in termini di capacità di servire più lavoro concorrente, non di maggiore velocità del singolo calcolo.
Per capire – Concorrenza, throughput e latenza. La concorrenza è quante richieste sono in corso nello stesso intervallo. Il throughput è quante richieste finiscono in un secondo. La latenza è quanto aspetta una singola richiesta prima del risultato. Se ogni richiesta dura in media 50 millisecondi e il servizio completa 200 richieste al secondo, in media circa 10 richieste sono in corso:
200 × 0,050 = 10. Per completarne 2.000 al secondo alla stessa durata, ne servono circa 100 contemporanee. È una relazione fra medie, non una promessa di prestazioni. Ridurre il costo dei thread che aspettano può permettere più richieste in corso; non fa diventare più breve la risposta del database.
Che cosa esegue il codice mentre il thread aspetta
Anche un thread virtuale esegue istruzioni su un thread del sistema operativo: non esiste una CPU «virtuale» aggiuntiva. La JVM assegna temporaneamente il thread virtuale a un thread di piattaforma, chiamato carrier. Finché il codice Java calcola, il carrier lo esegue. Quando il thread virtuale incontra un'operazione bloccante supportata dal runtime, per esempio l'attesa di dati da un socket, la JVM può sospenderlo e liberare il carrier. Il carrier esegue allora un altro thread virtuale. Quando i dati arrivano, il thread sospeso diventa nuovamente eseguibile e può riprendere su un carrier, anche diverso dal precedente. Il programma continua dopo la chiamata bloccante come se avesse semplicemente aspettato.

Definizione – Sospensione e carrier. Sospendere un thread virtuale significa conservare il punto da cui riprenderà, inclusa la sua catena di chiamate. Il carrier è il thread di piattaforma che lo sta eseguendo in quel momento. Il carrier non appartiene per sempre al thread virtuale: dopo un'attesa può eseguirne un altro.
Thread.currentThread()nel codice della richiesta continua a identificare il thread virtuale, non il carrier.
Questa distinzione spiega anche che cosa non cambia. synchronized, volatile, le eccezioni, l'interruzione e le regole di visibilità della memoria restano regole dei thread Java. Un incremento non protetto può andare perso anche se entrambi i partecipanti sono virtuali. Inoltre, non ogni chiamata bloccante libera sempre il carrier: in Java 25 il codice nativo o una foreign function possono trattenere l'associazione, situazione chiamata pinning. Un'attesa lunga mentre il thread è bloccato così può ridurre la capacità del servizio. Non è un motivo per evitare automaticamente i thread virtuali; è un motivo per osservare il carico e le operazioni effettive. La guida Java 25 distingue questo caso dal normale uso dei blocchi synchronized.
Una richiesta, un thread virtuale, un confine di vita
Per una piccola prova si può creare il thread direttamente: Thread.ofVirtual().name("prestito-1").start(lavoro) lo avvia e restituisce un Thread su cui chiamare join(). In un servizio che riceve molte richieste, Executors.newVirtualThreadPerTaskExecutor() crea invece un thread virtuale nuovo per ogni attività inviata. Non è un pool di thread virtuali da riempire e riutilizzare. La separazione è utile perché l'applicazione può descrivere il lavoro con un Callable e poi gestire il risultato tramite Future, come nel programma EsecutoreVirtuale che segue. Il try con risorse chiude l'esecutore dopo il lavoro e rende esplicito quando le attività devono essere terminate.
Il vantaggio atteso emerge se molte attività indipendenti aspettano spesso I/O. Non emerge nel piccolo calcolo di 22 più 33 del nostro esempio: quel programma serve a leggere l'API, non a misurare una velocità. La risorsa esterna ha comunque i propri limiti. Se il catalogo remoto accetta venti richieste contemporanee, creare diecimila thread virtuali non gli conferisce una capacità maggiore. Un Semaphore con venti permessi può limitare gli accessi al catalogo, mentre i thread virtuali in attesa di un permesso non occupano inutilmente un carrier. Il semaforo limita l'accesso alla risorsa scarsa; il numero di thread descrive quante attività esistono. Sono due decisioni diverse.
Quando servono davvero. Scegli un thread virtuale per un'attività indipendente che passa una parte rilevante della sua vita ad aspettare I/O: una richiesta HTTP, una query o una lettura di rete sono esempi tipici. Se il lavoro calcola continuamente, il limite resta il numero di core. Se condividi stato modificabile, devi ancora coordinare gli accessi. Se avvii un'attività che deve finire prima della risposta o della chiusura del programma, devi ancora attenderla e gestire il fallimento. Nessuno di questi compiti viene svolto automaticamente dalla parola virtuale.
Due limiti che restano: stato condiviso e risorse esterne
Il meccanismo del carrier spiega il costo di molte attese, ma non modifica il contratto del Java Memory Model. Gli esempi di synchronized, volatile e BlockingQueue mantengono la stessa semantica se passiamo da Thread.ofPlatform() a Thread.ofVirtual(). Un aggiornamento non protetto resta una race condition; il programma deve scegliere il protocollo di accesso allo stato condiviso.
Anche l'attesa economica non rende illimitata la risorsa attesa. Ogni attività conserva dati, riferimenti e lavoro da completare; un database o un servizio remoto può accettare meno richieste di quante la JVM possa avviare. Se cento mila attività chiedono una connessione a un database con poche connessioni disponibili, il problema diventa la pressione sul servizio e sulle code. Il semaforo dell'esempio precedente limita gli accessi al catalogo, mentre una coda limitata può impedire di accumulare richieste senza fine. Il thread virtuale rende conveniente aspettare; non crea capacità nel database.
Un ciclo che occupa continuamente la CPU resta limitato dai core e dalla memoria. Possiamo allora distinguere tre domande prima di scegliere la forma concorrente: l'attività aspetta soprattutto I/O, calcola senza pause oppure contende uno stato condiviso? I thread virtuali rispondono soprattutto alla prima; la seconda richiede una misura del carico e la terza un protocollo corretto. Questa distinzione prepara il confronto con gli stream paralleli.
Collegamento – Stream paralleli e thread. Una stream pipeline può essere richiesta in forma parallela, ma il codice al suo interno deve comunque rispettare le regole dello stato condiviso. Un accumulatore mutabile catturato da una lambda può avere una race condition tanto quanto un campo aggiornato da due
Thread. La parallelizzazione di una pipeline non risolve la semantica dell'operazione né assicura velocità maggiore. Le attività con molte attese di I/O e le trasformazioni dati CPU hanno profili diversi; per questo non sostituiamo automaticamente un esecutore di thread virtuali conparallelStream().
Servizi di esecuzione e confini del lavoro
Gestire a mano un oggetto Thread per ogni operazione è utile per capire il modello, ma applicazioni più grandi spesso separano la descrizione del lavoro dalla politica di esecuzione. Un ExecutorService accetta attività; un Future<T> può rappresentare un risultato da attendere, distinguendo il valore, un'eccezione e una cancellazione. Un pool di thread di piattaforma può limitare la concorrenza; un esecutore per thread virtuali può offrire un thread virtuale a ogni attività. La chiusura dell'esecutore è parte del contratto: non lasciamo risorse aperte dopo l'uso.
Il programma stabile che segue mostra il confine di vita con Future e la chiusura dell'esecutore. Subito dopo esamineremo la domanda che questa coppia lascia al chiamante: come trattare più lavori figli come una sola richiesta. L'API StructuredTaskScope di Java 25 affronta quel problema, ma è ancora preview; il suo stato viene chiarito nell'approfondimento dedicato.
Il programma EsecutoreVirtuale usa Executors.newVirtualThreadPerTaskExecutor() e passa due Callable<Integer> attraverso submit. Il tipo Callable, diversamente da Runnable, produce un risultato e può lanciare un'eccezione. Ogni chiamata restituisce un Future<Integer>, sul quale get() attende il completamento e restituisce il valore oppure segnala il fallimento. I due lavori calcolano 22 e 33; il programma stampa 55. L'esecutore viene chiuso dal costrutto try con risorse, che rende visibile la durata del servizio di esecuzione. L'esempio non mostra un beneficio prestazionale, perché i due calcoli sono minuscoli; mostra come rappresentare attività con risultato e un confine di vita esplicito.
Se un'attività fallisce, Future.get() può lanciare ExecutionException, la cui causa è l'eccezione prodotta dal lavoro. Se chi aspetta viene interrotto, riceve InterruptedException. Queste risposte sono diverse da «il risultato è zero» e non vanno cancellate con un catch vuoto. Anche Future.cancel richiede una scelta: può richiedere un'interruzione del lavoro, ma il lavoro deve cooperare e la cancellazione non annulla retroattivamente gli effetti già avvenuti. Un esercizio serio sugli esecutori deve quindi includere il percorso di errore e di chiusura, oltre al risultato felice.
Uno sguardo alle attività figlie in Java 25
Una richiesta applicativa può aver bisogno di due risposte indipendenti prima di costruire una pagina: per esempio il profilo di un libro e la disponibilità del magazzino. Con due Future sappiamo avviare i lavori e aspettarne i valori, ma dobbiamo ancora definire insieme cosa fare se uno fallisce o se il chiamante viene interrotto. Il problema non è soltanto «eseguire in parallelo»: è far coincidere la durata dei lavori figli con la durata della richiesta che li ha creati. Se la richiesta non serve più, lasciare in giro un lavoro che continua a occupare risorse può essere uno spreco o un errore.
La concorrenza strutturata affronta questa relazione tra attività padre e figlie. In Java 25 StructuredTaskScope è ancora una API preview; i dettagli e le firme possono cambiare. Per questo non la usiamo nei programmi principali né la presentiamo come prerequisito per risolvere il produttore-consumatore. È utile però conoscere l'idea: un ambito lessicale raccoglie i lavori figli e fa sì che il chiamante ne gestisca conclusione e fallimento prima di abbandonare quell'ambito. Un esempio eseguibile basato su questa API richiederebbe --enable-preview sia a javac sia a java, oltre alle altre opzioni di versione richieste dalla compilazione.
Perché lo stato conta. Un'API preview fa parte di un JDK rilasciato, ma viene offerta per raccogliere esperienza prima di una forma definitiva. Una API incubator, come la Vector API del capitolo C23, vive in un modulo sperimentale. Il lettore può provare entrambe, ma una libreria destinata a molti ambienti non dovrebbe nascondere queste dipendenze dietro un esempio che sembra stabile. Nel corpo principale di C20 usiamo soltanto API stabili del JDK 25.
ScopedValue è invece definitiva in Java 25. Descrive un valore associato a un ambito di esecuzione, utile per passare informazioni di contesto immutabili lungo una catena di chiamate senza aggiungere lo stesso parametro a ogni metodo. Non è una variabile globale da modificare liberamente: il suo valore è legato a un ambito e segue regole precise di visibilità. Se una richiesta porta un identificatore per il log, un valore con ambito può essere più adatto di un campo statico condiviso da tutte le richieste. Non serve però a coordinare l'incremento del contatore o la disponibilità di un prodotto; quei problemi riguardano modifiche condivise e attese.
Il programma ContestoRichiesta.java rende osservabile la durata del legame. ID_RICHIESTA è la chiave condivisa dal codice, non il valore della richiesta: ScopedValue.newInstance() la crea inizialmente senza valore associato. where(...).run(...) associa P-17 soltanto durante quella chiamata. preparaRisposta invoca un altro metodo che legge il valore con get() pur senza riceverlo come parametro. Dopo il ritorno da run, isBound() torna a false. Usare get() fuori dall'ambito lancerebbe NoSuchElementException; l'esempio controlla invece isBound() per mostrare il confine senza trasformare l'errore in un risultato normale.
public class ContestoRichiesta {
private static final ScopedValue<String> ID_RICHIESTA = ScopedValue.newInstance();
private static void registra(String azione) {
System.out.println(ID_RICHIESTA.get() + ": " + azione);
}
private static void preparaRisposta() {
registra("catalogo consultato");
}
public static void main(String[] args) {
System.out.println("Prima: " + ID_RICHIESTA.isBound());
ScopedValue.where(ID_RICHIESTA, "P-17").run(ContestoRichiesta::preparaRisposta);
System.out.println("Dopo: " + ID_RICHIESTA.isBound());
}
}
Compila con javac --release 25 -Xlint:all -d build ContestoRichiesta.java ed esegui java -cp build ContestoRichiesta: l'output è Prima: false, P-17: catalogo consultato, Dopo: false. Cambia P-17 in P-18 e prevedi quale riga varia. Poi chiediti perché sostituire il valore con un contatore mutabile richiederebbe regole ulteriori: ScopedValue trasmette un contesto, ma non protegge le modifiche a un oggetto condiviso. Il programma rimane sul solo percorso stabile di Java 25; la trasmissione ai thread figli creati con StructuredTaskScope richiederebbe invece la API preview e viene lasciata all'approfondimento precedente.
Questi due strumenti illuminano una distinzione importante. Il contesto di una richiesta può essere trasmesso a funzioni figlie senza essere aggiornato in concorrenza; lo stato di una coda o di un saldo viene invece modificato da più attività e richiede un protocollo. Se confondiamo i due casi, rischiamo di usare un lock per ogni dato di contesto oppure di usare un valore contestuale dove servirebbe una transazione. Le novità del linguaggio e della libreria non cancellano le domande fondamentali: chi possiede il dato, chi può cambiarlo e quando l'operazione è conclusa.
Dare un nome al lavoro e capire chi mantiene viva la JVM
I nomi dei thread non determinano il loro comportamento, ma aiutano a leggere un log o una traccia. Nell'esempio AvvioEJoin, il nome lavoratore rende visibile il passaggio dalla chiamata diretta di run() al thread realmente avviato. In un server conviene usare nomi che descrivano il ruolo o il tipo di attività, non numeri senza contesto. Il nome può essere duplicato e può cambiare: è un aiuto diagnostico, non un identificatore globale di identità. Per sapere quale thread sta eseguendo una riga si può chiamare Thread.currentThread(); stampare questo riferimento in un esercizio è più utile che supporre da quale thread arrivi una chiamata.
Un thread di piattaforma può essere daemon o non daemon. La JVM può terminare quando non restano thread non daemon, senza aspettare che i daemon finiscano il proprio lavoro. Per questo un daemon è adatto a certe attività di supporto che non devono mantenere vivo il processo; non è il posto giusto per salvare l'ultimo dato essenziale alla chiusura se non esiste un protocollo esplicito. setDaemon(true) va chiamato prima di start() sul thread a cui si applica. Un thread virtuale è sempre daemon secondo il contratto dell'API: questo rende ancora più importante attendere esplicitamente le attività che contano, per esempio tramite join, Future.get() o la chiusura dell'esecutore. La fine del metodo main non deve essere usata come sostituto della gestione della durata delle attività.
Approfondimento – Durata del thread e durata dell'operazione. Un thread può esistere più a lungo dell'oggetto che lo ha creato, se nessuno lo attende o lo ferma. Un'operazione applicativa, invece, ha un momento in cui il chiamante deve poter dire se è conclusa, fallita o ancora in corso. Collegare le due durate è responsabilità del programma. La forma
trycon unExecutorServiceè un modo per rendere visibile quel confine; creare thread anonimi senza conservarne i riferimenti può renderlo opaco.
La distinzione fra Runnable e sottoclasse di Thread merita una spiegazione più ampia di una preferenza di stile. Runnable descrive un compito mediante il metodo run(). La stessa istanza di Runnable può essere passata a un Thread, a un esecutore o richiamata direttamente in un test, pur con semantiche di esecuzione diverse. Una sottoclasse di Thread combina in un unico oggetto compito e politica di esecuzione; può essere utile in casi particolari, ma occupa anche l'unica classe da cui Java permette di ereditare. Una lambda è spesso la forma più breve di un Runnable, purché il corpo resti leggibile e la cattura di variabili non nasconda stato condiviso pericoloso.
Runnable lavoro = () -> System.out.println(Thread.currentThread().getName());
Thread thread = new Thread(lavoro, "lettore");
thread.start();
thread.join();
Il frammento presuppone un metodo che dichiari o gestisca InterruptedException per join. Il Runnable non riceve automaticamente il nome lettore: il nome appartiene al Thread che lo esegue. Se chiamassimo lavoro.run() direttamente, il nome sarebbe quello del chiamante. È la stessa distinzione osservata nel programma completo, ora espressa nella forma che useremo più spesso.
Thread offre diversi costruttori che ricevono un Runnable. Tutti creano un thread di piattaforma non ancora avviato: dopo la costruzione occorre chiamare start(). Il parametro target indica il lavoro; il nome aiuta la diagnosi, mentre il gruppo e la dimensione dello stack rispondono a esigenze più specifiche.
| Costruttore | Che cosa aggiunge |
|---|---|
Thread(Runnable target) |
Un lavoro con un nome generato dalla piattaforma. |
Thread(Runnable target, String name) |
Un nome scelto dal programma. |
Thread(ThreadGroup group, Runnable target) |
Un gruppo di thread esplicito. |
Thread(ThreadGroup group, Runnable target, String name) |
Gruppo e nome espliciti. |
Thread(ThreadGroup group, Runnable target, String name, long stackSize) |
Anche una richiesta approssimativa per la dimensione dello stack. |
Il gruppo non è necessario per i piccoli esempi di questo capitolo: serve soprattutto quando un'applicazione esistente organizza i thread di piattaforma in gruppi. La dimensione stackSize è espressa in byte, ma la JVM e il sistema operativo possono interpretarla in modo diverso o non applicarla; non va usata come garanzia di una certa profondità di ricorsione. In Java 25 si possono anche usare i builder Thread.ofPlatform() e Thread.ofVirtual(): rendono esplicito il tipo di thread e permettono di comporre alcune opzioni prima dell'avvio. La scelta del costruttore non cambia la semantica di Runnable.run() né rende sicuro l'accesso a dati condivisi.
La sincronizzazione è un accordo fra tutti i partecipanti
Per capire perché il contatore protetto funziona, seguiamo una possibile intercalazione. Il primo thread entra in incrementa, acquisisce il monitor di contatore, legge 10, calcola 11 e lo scrive. Il secondo thread può essere pronto nello stesso momento, ma non può entrare in quello stesso metodo protetto sullo stesso oggetto prima che il primo rilasci il monitor. Quando entra, legge il nuovo valore secondo le garanzie di memoria del lock. Non è necessario indovinare quale thread sarà il primo: entrambe le sequenze ammesse producono due incrementi. La correttezza nasce dal fatto che ogni incremento è racchiuso nello stesso protocollo.
Supponiamo invece che un'altra classe riceva il riferimento al contatore e modifichi direttamente un campo pubblico valore. Anche se incrementa è synchronized, quella scrittura non partecipa al protocollo e può interferire. L'incapsulamento del campo è quindi parte della soluzione: rendere valore privato impedisce al codice esterno di aggirare accidentalmente il lock. Un metodo leggi protetto dallo stesso monitor rende la regola facile da applicare. Quando lo stato condiviso è distribuito fra più oggetti, serve decidere quale componente possiede l'invariante; spargere synchronized su oggetti diversi non crea per magia un unico confine.
L'uso di un blocco sincronizzato richiede inoltre di scegliere il lock senza esporlo. synchronized(this) può essere corretto quando l'intero oggetto ha un protocollo noto, ma consente a un chiamante che possiede il riferimento di acquisire lo stesso monitor e trattenere l'oggetto. Un lock privato rende il protocollo interno meno soggetto a interferenze esterne. La scelta dipende dal contratto della classe: un componente che vuole permettere esplicitamente ai chiamanti di sincronizzarsi su di esso ha esigenze diverse. Nella maggior parte delle classi applicative, un lock privato riduce le sorprese.
Il monitor è rientrante: un thread che lo possiede può entrare di nuovo in un metodo sincronizzato sullo stesso oggetto, per esempio quando incrementa() chiama un altro metodo synchronized della stessa istanza. Non va confuso con l'assenza di deadlock: la rientranza riguarda lo stesso thread e lo stesso monitor. Il deadlock descritto in precedenza coinvolge più thread e più risorse, con un ciclo di attese. Una classe può quindi essere corretta rispetto alla rientranza e ancora pericolosa se prende lock differenti in ordini diversi.
Nota di lettura –
synchronizede output. Se due thread eseguono metodi sincronizzati dello stesso oggetto e ciascuno stampa una riga, il lock può serializzare quelle sezioni, ma non decide quale thread entrerà per primo. Un output A poi B e un output B poi A possono essere entrambi corretti. Se l'ordine è requisito del problema, bisogna codificarlo con una condizione o con un canale di passaggio, non sperare che il lock favorisca sempre lo stesso lavoratore.
Cosa accade davvero quando un thread aspetta
Il metodo Object.wait() appartiene all'oggetto usato come monitor e richiede che il thread lo possieda. La chiamata inserisce il thread nell'insieme di attesa dell'oggetto, rilascia il monitor e sospende l'avanzamento finché un evento previsto dalla specifica lo risveglia. Dopo il risveglio il thread deve riacquisire il monitor prima di ritornare dalla chiamata. Per questo un produttore che chiama notifyAll() mentre possiede ancora il monitor non consegna immediatamente il controllo al consumatore: prima deve uscire dalla sezione sincronizzata.
notify() seleziona un thread in attesa senza promettere quale; notifyAll() rende tutti i thread in attesa candidati a proseguire, uno alla volta per l'acquisizione del monitor. Nel deposito a un solo posto, produttore e consumatore aspettano condizioni opposte sullo stesso oggetto. Se si usasse notify() in una variante con più produttori e più consumatori, si potrebbe risvegliare un thread che trova ancora falsa la propria condizione, lasciando fermo quello che avrebbe potuto avanzare. notifyAll() non elimina la necessità del while, ma evita di basare il protocollo sulla scelta non garantita del thread risvegliato.
La variante temporizzata wait(millis) non trasforma l'attesa in un appuntamento esatto. Può ritornare per notifica, interruzione, risveglio spurio o trascorso del tempo. Il codice deve ricontrollare la condizione e, se esiste una scadenza complessiva, ricalcolare quanto tempo resta. Ripetere wait(1000) in un ciclo senza aggiornare il tempo potrebbe attendere molto più del limite che il chiamante immaginava. Per molte applicazioni le astrazioni di java.util.concurrent, come code e lock con condizioni, riducono il rischio di sbagliare questi dettagli; capire wait rimane comunque utile per leggere codice esistente e la semantica su cui si basano vari strumenti.
Approfondimento – Interruzione durante
wait. Se un thread viene interrotto mentre aspetta,waitlanciaInterruptedExceptiondopo aver riacquisito il monitor secondo le regole della specifica. Il metodo chiamante deve decidere se propagare l'eccezione, ripristinare il segnale e terminare, oppure gestire esplicitamente una chiusura. Catturare l'eccezione e ripetere subito ilwhilesenza politica può trasformare una richiesta di arresto in un'attesa infinita.
Una coda è anche una decisione sul carico
Fin qui abbiamo visto BlockingQueue come rimedio al problema di leggere un elemento non ancora prodotto. C'è un secondo problema: quanto lavoro permettiamo al produttore di accumulare? Se il produttore genera cento elementi al secondo e il consumatore ne usa cinquanta, una coda che cresce senza un limite definito accumula il ritardo. All'inizio tutto sembra funzionare; dopo un'ora la memoria occupata e il tempo necessario a recuperare il lavoro possono essere molto grandi. Una coda limitata rende visibile la differenza di velocità: quando è piena, put sospende il produttore finché il consumatore libera spazio. Questo meccanismo si chiama spesso backpressure, cioè pressione di ritorno dal lato che consuma verso quello che produce.
Il numero due dell'esempio è scelto per vedere facilmente il blocco, non è una capacità da usare in ogni applicazione. Per scegliere una capacità reale bisogna conoscere dimensione degli elementi, frequenza di produzione, tempi di consumo e latenza accettabile. Una coda molto piccola può frenare inutilmente un produttore che lavora a raffiche brevi; una molto grande può nascondere un consumatore cronicamente in ritardo. La capacità non sostituisce i limiti sull'intero sistema: più code, più richieste e più istanze possono sommare memoria anche quando ciascuna coda è formalmente limitata.
Una LinkedBlockingQueue può essere costruita con una capacità esplicita; senza una capacità applicativa scelta dal progettista ha un limite tecnico molto grande. Una ArrayBlockingQueue ha capacità fissata alla costruzione. Queste differenze contano più della preferenza per un nome di classe: il contratto di pieno e vuoto deve essere chiaro a chi chiama. Anche la scelta fra offer e put riflette una politica. Con offer immediato il produttore può rifiutare lavoro quando la coda è piena; con put aspetta; con offer temporizzato concede una finestra e poi restituisce false. Quale dei tre sia corretto dipende dalla promessa fatta all'utente o al componente che invia il lavoro.
Caso concreto – Una richiesta web. Un servizio che riceve un ordine non dovrebbe rispondere «accettato» se ha soltanto tentato
offere ha ricevutofalse. Deve riconoscere il rifiuto e comunicarlo, riprovare secondo una politica dichiarata o usare una consegna affidabile diversa dalla memoria del processo. La coda di questo capitolo è volatile: se il processo termina, il suo contenuto non diventa automaticamente persistente. Il buon uso della concorrenza comincia dal significato delle risposte, non dal numero di thread.
Quando due consumatori condividono una coda, ogni elemento prelevato va a uno solo dei due. La coda non duplica il messaggio. Se entrambi devono vedere tutti gli elementi, serve un modello di pubblicazione differente, con una copia o un canale per ciascuno. Due consumatori di una stessa coda sono quindi lavoratori che si dividono il carico, non osservatori che ricevono entrambi lo stesso flusso. Il loro ordine di stampa cambia fra esecuzioni, ma il requisito utile è che nessun elemento venga perso o consumato due volte in quel modello.
La fine del lavoro è un messaggio del protocollo. La sentinella -1 nell'esempio non appartiene ai dati normali, quindi comunica «non arriveranno altri numeri». Con due consumatori e una sola sentinella, uno può terminare e l'altro rimanere bloccato in take(). Occorre inserire due sentinelle, una per ciascun consumatore, oppure disegnare un altro meccanismo di chiusura. Se il numero dei consumatori varia durante l'esecuzione, le sentinelle richiedono particolare attenzione: bisogna sapere chi è attivo al momento della chiusura. Un'astrazione più alta può rendere più semplice questo contratto, ma non può decidere al posto dell'applicazione che cosa significhi «fine».
L'interruzione è un altro possibile evento di chiusura. Un consumatore bloccato in take() può essere interrotto; il metodo lancia InterruptedException. Se il ciclo cattura l'eccezione e continua senza criterio, la richiesta di arresto non viene rispettata. Se esce, il programma deve decidere cosa fare degli elementi già prelevati o rimasti nella coda. In una prova didattica stampare i valori è sufficiente; in un sistema di ordini servono regole su conferma, ripetizione ed eventuale perdita. Il capitolo conserva il modello semplice per insegnare la sincronizzazione, ma esplicita il limite della soluzione.
Dalla stampa casuale alla verifica corretta
La concorrenza invita a eseguire il programma una volta e a trarre conclusioni dall'ordine osservato. Molte righe prodotte da thread con priorità diverse o da più consumatori mostrano una sola esecuzione: non descrivono tutte le intercalazioni possibili. Un test di concorrenza deve formulare proprietà che restano vere sotto intercalazioni diverse. Per il contatore protetto la proprietà è «dopo che entrambi i thread sono terminati, il valore è ventimila». Per la coda con un produttore e un consumatore è «i valori zero-quattro sono ricevuti nell'ordine d'inserimento e il consumatore termina». Per due consumatori è «ogni valore è ricevuto una sola volta nel totale», senza vincolare il nome del lavoratore che lo riceve.
L'assenza di un errore in cento esecuzioni non dimostra l'assenza di una race condition. Un programma difettoso può stampare sempre il valore atteso sulla nostra macchina e fallire solo con un carico diverso. Viceversa, un output in ordine diverso non è per forza un errore: può essere una delle sequenze consentite dal contratto. Separare proprietà del programma e dettagli della pianificazione è un passo fondamentale per testare la concorrenza senza inventare garanzie.
Un modo utile di leggere un programma concorrente consiste nel tracciare gli eventi che devono essere ordinati. Nel contatore: avvio dei due lavoratori, ciascun incremento sotto il monitor, loro conclusione, ritorno di entrambe le join, lettura del risultato. Gli incrementi del primo e del secondo non hanno un ordine globale prefissato, ma sono serializzati quando entrano nello stesso metodo sincronizzato. La lettura finale avviene dopo le due conclusioni. Se togliamo join, la lettura potrebbe avvenire prima che tutti gli incrementi siano stati tentati, anche se ogni incremento fosse atomico. Sono due errori diversi: mancanza di attesa del completamento e mancanza di protezione degli aggiornamenti.
Per il deposito manuale, la traccia parte dallo stato «vuoto». preleva che arriva per primo aspetta e rilascia il monitor. inserisci(0) entra, trova il posto libero, scrive zero e notifica. Il consumatore torna candidato, riacquisisce il monitor, ricontrolla prodotto != null, prende zero, svuota il posto e notifica. Se il produttore arriva prima, inserisce zero; il consumatore lo trova senza dover attendere. Entrambe le storie rispettano lo stesso contratto. La spiegazione del protocollo deve funzionare per entrambe, altrimenti dipende da un ordine favorevole e non dal codice.
Metodo di lettura – Tre colonne. Per analizzare un caso difficile, si può disegnare una colonna per ciascun thread e una per lo stato condiviso. Si scrivono letture, scritture, acquisizioni dei lock e attese. Non è necessario elencare ogni istruzione locale: interessano gli eventi che possono influire sull'altro thread. Questo schema rende visibile la lettura doppia del vecchio saldo, il
whileche protegge il deposito e il ciclo di attesa di un deadlock.
La verifica automatica può ripetere gli esperimenti, ma deve avere un limite di tempo per non restare bloccata su un errore di terminazione. Per un esempio che usa interruzioni o code, un test che non termina è già un difetto rilevante. Invece di dormire un tempo arbitrario e sperare che tutto sia finito, il test attende le attività con join o Future.get() e controlla la proprietà finale. Se deve evitare attese infinite, usa una variante con timeout e poi gestisce esplicitamente l'attività ancora in corso. Anche in un test, un timeout non è una cancellazione implicita.
Laboratorio: ricostruire gli esempi senza nascondere i passaggi
I programmi usati nei paragrafi precedenti sono piccoli perché ogni prova isola una proprietà. Metterli uno accanto all'altro permette di vedere quali righe hanno un ruolo di coordinamento e quali appartengono al lavoro applicativo. I file completi sono collegati ai rispettivi paragrafi; qui seguiamo una lettura progressiva. Il lettore può compilare ogni sorgente con javac --release 25 -Xlint:all e confrontare le righe osservate con le proprietà previste. Nessuno richiede opzioni preview.
Primo passaggio: avviare e attendere
Il programma AvvioEJoin chiama il medesimo Runnable in due modi. Nel primo caso l'esecuzione rimane nel thread main. Nel secondo start crea una nuova attività e join permette di osservare lo stato concluso. La riga che stampa dopo run diretto: NEW è decisiva: l'oggetto Thread è ancora nuovo, benché il metodo run sia stato eseguito come normale chiamata. Quando si rilegge il codice, conviene indicare con un segno il punto in cui l'attività concorrente nasce davvero.
public class AvvioEJoin {
public static void main(String[] args) throws InterruptedException {
Runnable lavoro = () -> System.out.println(
"esegue: " + Thread.currentThread().getName());
Thread lavoratore = new Thread(lavoro, "lavoratore");
System.out.println("prima: " + lavoratore.getState());
lavoratore.run();
System.out.println("dopo run diretto: " + lavoratore.getState());
lavoratore.start();
lavoratore.join();
System.out.println("dopo join: " + lavoratore.getState());
}
}
La sequenza stampata è NEW, main, ancora NEW, lavoratore, TERMINATED, con le etichette del programma. Non è una coincidenza favorevole dello scheduler: la prima chiamata precede start, e l'ultima stampa segue join. Se togliamo join, il programma può osservare RUNNABLE o TERMINATED a seconda del momento, e non può dichiarare completato il lavoro soltanto perché ha chiamato start.
Secondo passaggio: proteggere un aggiornamento
Nel contatore seguente il lavoro dei due thread è identico. Il metodo incrementa è breve, ma è proprio il punto in cui una lettura, un calcolo e una scrittura devono apparire come una sezione non interferita dall'altro thread. Anche la lettura finale passa dal metodo sincronizzato leggi. Il programma aspetta la conclusione di entrambi i thread prima di chiedere il valore. Se si cambiasse il numero di iterazioni a 100, il risultato atteso diventerebbe 200: il ragionamento non dipende dalla cifra particolare diecimila.
public class ContatoreProtetto {
private int valore;
public synchronized void incrementa() {
valore++;
}
public synchronized int leggi() {
return valore;
}
public static void main(String[] args) throws InterruptedException {
ContatoreProtetto contatore = new ContatoreProtetto();
Runnable lavoro = () -> {
for (int i = 0; i < 10_000; i++) {
contatore.incrementa();
}
};
Thread primo = Thread.ofPlatform().start(lavoro);
Thread secondo = Thread.ofPlatform().start(lavoro);
primo.join();
secondo.join();
System.out.println(contatore.leggi());
}
}
Un esperimento utile consiste nel togliere synchronized solo da incrementa in una copia del file. Il codice continua a compilare e può persino stampare 20000; questo non dimostra che sia corretto. Il lettore deve individuare il punto in cui due intercalazioni possono leggere lo stesso vecchio valore. Ripristinata la versione protetta, si può cambiare il numero dei lavoratori, conservando un riferimento a ciascuno e chiamando join su tutti prima della lettura.
Terzo passaggio: separare visibilità e incremento
Il segnale di arresto usa volatile perché una scrittura di true deve essere osservata dal lavoratore. Il programma non incrementa un contatore nello stesso campo e non pretende che la parola chiave renda indivisibili più istruzioni. onSpinWait() è incluso per mostrare che il ciclo è un'attesa attiva; il programma lo termina subito. Per una vera attesa di durata incerta sarebbe più appropriato un meccanismo bloccante o una richiesta di interruzione gestita esplicitamente.
public class SegnaleVolatile {
private volatile boolean fermati;
public static void main(String[] args) throws InterruptedException {
SegnaleVolatile segnale = new SegnaleVolatile();
Thread lavoratore = Thread.ofPlatform().start(() -> {
while (!segnale.fermati) {
Thread.onSpinWait();
}
System.out.println("fermato");
});
segnale.fermati = true;
lavoratore.join();
}
}
Qui main potrebbe scrivere true prima che il nuovo thread cominci davvero a eseguire il ciclo. Anche quel caso è corretto: il lavoratore leggerà il valore e uscirà. La prova non richiede che i due thread si alternino in un ordine speciale. Se si togliessero sia volatile sia ogni altra forma di sincronizzazione sul campo, il programma non avrebbe il contratto di visibilità su cui questa spiegazione si basa; non è un esperimento da lanciare senza un limite di tempo perché potrebbe non terminare.
Quarto passaggio: un deposito con un posto
Il deposito manuale raccoglie ciò che abbiamo imparato su monitor, condizione e risveglio. Il campo prodotto è l'unico posto disponibile. null significa «vuoto», mentre ogni intero inserito, compresa la sentinella -1, significa «pieno». Un metodo non può leggere il valore quando il posto è vuoto e l'altro non può sovrascriverlo quando è pieno. Il while custodisce queste due invarianti anche dopo un risveglio non utile. Per osservare la coda di eventi, possiamo compilare il file e verificare che le cinque righe prelevato contengano, nell'ordine, zero, uno, due, tre e quattro.
public class DepositoConAttesa {
private Integer prodotto;
public synchronized void inserisci(int numero) throws InterruptedException {
while (prodotto != null) {
wait();
}
prodotto = numero;
notifyAll();
}
public synchronized int preleva() throws InterruptedException {
    while (prodotto == null) {
        wait();
    }
    int numero = prodotto;
    prodotto = null;
    notifyAll();
    return numero;
}
public static void main(String[] args) throws InterruptedException {
DepositoConAttesa deposito = new DepositoConAttesa();
Thread produttore = Thread.ofPlatform().start(() -> {
try {
for (int numero = 0; numero < 5; numero++) {
deposito.inserisci(numero);
}
deposito.inserisci(-1);
} catch (InterruptedException e) {
Thread.currentThread().interrupt();
}
});
Thread consumatore = Thread.ofPlatform().start(() -> {
try {
while (true) {
int numero = deposito.preleva();
if (numero == -1) {
break;
}
System.out.println("prelevato: " + numero);
}
} catch (InterruptedException e) {
Thread.currentThread().interrupt();
}
});
produttore.join();
consumatore.join();
}
}
Il percorso va dal deposito senza sincronizzazione a uno con attesa, poi a più consumatori. La progressione resta utile se ogni passo rende visibile l'invariante che mancava. Con un solo consumatore, la forma corretta evita letture premature. Con due consumatori, il lettore deve riconoscere che entrambi possono essere risvegliati ma uno solo potrà trovare un valore: chi arriva secondo torna ad aspettare grazie al while. Una versione con più consumatori richiede inoltre un protocollo di chiusura per tutti; copiare esattamente il main qui sopra e aggiungere un secondo consumatore senza cambiare la sentinella produrrebbe un programma che può non terminare.
Quinto passaggio: usare l'astrazione della libreria
Il deposito manuale insegna il meccanismo, ma ogni nuovo requisito richiede altro codice di protocollo. Una BlockingQueue dichiara già le operazioni di attesa e una capacità. Il programma seguente sostituisce il campo facoltativo e i due metodi sincronizzati con una coda limitata. Il lavoro applicativo non cambia: produrre cinque numeri, consumarli nell'ordine e terminare alla sentinella. Si può quindi confrontare il numero di decisioni che il programmatore deve prendere nelle due forme, senza sostenere che una coda risolva automaticamente tutti i problemi di chiusura.
import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.BlockingQueue;

public class ProduttoreConsumatore {
    private static final int FINE = -1;

    public static void main(String[] args) throws InterruptedException {
        BlockingQueue<Integer> coda = new ArrayBlockingQueue<>(2);
        Thread produttore = Thread.ofVirtual().name("produttore").start(() -> {
            try {
                for (int numero = 0; numero < 5; numero++) {
                    coda.put(numero);
                }
                coda.put(FINE);
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        });
        Thread consumatore = Thread.ofVirtual().name("consumatore").start(() -> {
            try {
                while (true) {
                    int numero = coda.take();
                    if (numero == FINE) {
                        break;
                    }
                    System.out.println("consumato: " + numero);
                }
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        });
        produttore.join();
        consumatore.join();
    }
}
I due thread qui sono virtuali, ma la coda applica le stesse condizioni di pieno e vuoto che avrebbe con thread di piattaforma. main aspetta entrambi. L'ordine delle stampe del solo consumatore è il contenuto ordinato del flusso; se aggiungessimo stampe nel produttore, le due serie di righe potrebbero intrecciarsi diversamente. Questa differenza fra ordine dei valori e ordine degli eventi di stampa va conservata quando si spiegano esempi concorrenti.
Sesto passaggio: un incremento atomico autonomo
Quando lo stato condiviso è un solo numero, AtomicInteger offre operazioni atomiche già definite. Il programma che segue non usa volatile int: l'operazione incrementAndGet comprende l'aggiornamento in modo atomico. get legge il valore finale dopo la conclusione dei due lavoratori. La somiglianza dell'output con ContatoreProtetto non significa che le due classi siano intercambiabili in ogni situazione. Se dovessimo mantenere coerenti più campi, un contatore atomico isolato non proteggerebbe l'intera invariante.
import java.util.concurrent.atomic.AtomicInteger;

public class ContatoreAtomico {
    public static void main(String[] args) throws InterruptedException {
        AtomicInteger valore = new AtomicInteger();
        Runnable lavoro = () -> {
            for (int i = 0; i < 10_000; i++) {
                valore.incrementAndGet();
            }
        };
        Thread primo = Thread.ofPlatform().start(lavoro);
        Thread secondo = Thread.ofPlatform().start(lavoro);
        primo.join();
        secondo.join();
        System.out.println(valore.get());
    }
}
Il nome incrementAndGet dice anche quale valore restituirebbe a chi lo chiama: il nuovo valore dopo l'incremento. getAndIncrement, invece, restituisce il valore precedente. Entrambi aggiornano atomicamente il numero, ma la differenza conta quando quel valore viene usato per assegnare un identificatore o una posizione. Nel programma non usiamo il valore di ritorno perché vogliamo soltanto contare; il valore finale viene letto una volta, dopo le join. Se si stampasse a ogni incremento, l'ordine delle ventimila righe non avrebbe un significato utile e la stampa stessa cambierebbe molto il profilo temporale dell'esperimento.
Settimo passaggio: attività con un risultato
L'esecutore virtuale separa la creazione dei lavori dalla gestione diretta dei riferimenti ai thread. Le due lambda passate a submit sono Callable<Integer> perché producono numeri. I Future rendono esplicito il momento in cui main vuole i risultati. get() può attendere; quando entrambe le chiamate sono terminate, la somma è deterministica. Il try con risorse chiude l'esecutore alla fine del blocco anche se un'operazione esce con un'eccezione gestita dal chiamante secondo il contratto dell'API.
import java.util.concurrent.ExecutionException;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.Future;

public class EsecutoreVirtuale {
    public static void main(String[] args)
            throws InterruptedException, ExecutionException {
        try (ExecutorService esecutore =
                Executors.newVirtualThreadPerTaskExecutor()) {
            Future<Integer> prima = esecutore.submit(() -> 20 + 2);
            Future<Integer> seconda = esecutore.submit(() -> 30 + 3);
            System.out.println(prima.get() + seconda.get());
        }
    }
}
In questo esempio il primo get potrebbe terminare prima del secondo, dopo il secondo o trovarlo già completato. La somma stampata resta 55 perché i due calcoli non condividono stato mutabile e main usa i risultati soltanto dopo averli ottenuti. Se sostituissimo i calcoli con due chiamate di rete, dovremmo decidere cosa fare quando una fallisce: aspettare l'altra, cancellarla, mostrare un risultato parziale o propagare l'errore. Il Future rappresenta lo stato del singolo lavoro, ma la politica complessiva appartiene all'operazione chiamante.
Piccola guida ai metodi di Thread
Raccogliamo in una tabella i metodi di java.lang.Thread che abbiamo incontrato. Alcuni sono facili da interpretare perché sembrano descrivere un'azione, ma il loro contratto richiede una precisazione. start() programma l'avvio di un nuovo thread; non attende che run() finisca. run() è il corpo del lavoro, ma una sua chiamata diretta rimane nel thread chiamante. currentThread() restituisce il thread che sta eseguendo in quel punto, non necessariamente quello da cui abbiamo ottenuto un riferimento in precedenza. join() aspetta la terminazione del thread su cui è invocato, mentre la variante con timeout può tornare anche se il thread è ancora vivo.
interrupt() segnala una richiesta di interruzione. isInterrupted() legge il segnale su un oggetto Thread senza cancellarlo; interrupted() è un metodo statico che opera sul thread corrente e cancella lo stato. sleep() sospende il thread corrente e può essere interrotto; non rilascia i monitor che il thread possiede. yield() offre un suggerimento allo scheduler. getState() fornisce uno degli stati osservabili al momento della chiamata: subito dopo, lo stato può essere già cambiato. Una misura che interroga ripetutamente getState() non sostituisce un protocollo di coordinamento.
setName e getName riguardano la diagnostica; setPriority e getPriority riguardano una proprietà la cui efficacia sulla pianificazione è dipendente dalla piattaforma e dal tipo di thread. setDaemon va deciso prima dell'avvio per i thread di piattaforma; isDaemon permette di osservarlo. Il metodo isAlive() risponde se il thread è stato avviato e non è ancora terminato, ma una risposta true non significa che sia su un core in quell'istante. Tutte queste domande riguardano la vita o la descrizione del thread; nessuna di esse rende atomico un aggiornamento a un oggetto condiviso.
| Metodo o gruppo | Domanda utile | Errore frequente |
|---|---|---|
start, run |
Nasce un thread nuovo oppure eseguo un metodo qui? | Chiamare run credendo di creare concorrenza |
join, isAlive |
Il lavoro è terminato? | Interpretare un timeout come completamento |
interrupt, isInterrupted, interrupted |
Come viene richiesta e osservata la chiusura? | Ingoiare l'interruzione o azzerarla senza saperlo |
sleep, yield |
Il thread corrente sospende o cede volontariamente? | Usarli come strumenti di sincronizzazione |
getState |
Quale stato è osservabile ora? | Supporre che lo stato resti uguale dopo la lettura |
getName, setName |
Come riconoscere il ruolo nei log? | Usare il nome come identità globale garantita |
getPriority, setPriority |
Quale priorità è configurata? | Pretendere un ordine di esecuzione fisso |
isDaemon, setDaemon |
Il thread tiene in vita la JVM? | Lasciare lavoro essenziale a un daemon non atteso |
Questa tabella è un indice per leggere le prove, non sostituisce le firme dell'API. Per esempio, join() può lanciare InterruptedException; setDaemon e setPriority hanno vincoli propri. Quando il comportamento è necessario alla correttezza, si consulta la documentazione della versione del JDK usata. La panoramica serve a collegare ogni metodo alla decisione pratica che il lettore deve prendere.
Un esperimento controllato sulle priorità
Si possono avviare due lavori finiti, ciascuno con un conteggio locale e una sola stampa finale, assegnando priorità differenti ai thread di piattaforma. Se ripetiamo la prova, può cambiare quale riga finale compare per prima. Il risultato non permette di inferire una legge come «la priorità alta termina sempre prima». Il sistema operativo, la JVM e il carico della macchina partecipano alla pianificazione; la specifica non trasforma la priorità in una precedenza funzionale fra risultati. Per rendere deterministico un ordine, si può far attendere il secondo lavoro con un coordinamento esplicito, ma a quel punto è il coordinamento a fornire la garanzia, non la priorità.
Una stampa continua in un ciclo senza fine amplificherebbe visivamente le differenze osservate su una macchina, ma renderebbe difficile fermare il programma e mescolerebbe il costo della console con la pianificazione dei thread. Limitiamo il numero di iterazioni e dichiariamo che l'ordine di arrivo non è un'asserzione di test. L'osservazione critica dello scheduler insegna che quando non definiamo una relazione fra le attività, non possiamo usare l'intercalazione delle loro stampe come parte del contratto del programma.
Scegliere il modello partendo dal bisogno
Ricapitoliamo tre richieste diverse. Se dobbiamo contare accessi indipendenti, un AtomicInteger può essere sufficiente. Se dobbiamo cambiare insieme saldo e storico di un conto, serve una sezione critica che protegga l'intera invariante, oppure una transazione al livello che possiede i dati. Se dobbiamo trasferire lavoro da un produttore a un consumatore, una BlockingQueue esprime il passaggio e la disponibilità. Usare il medesimo strumento per tutti e tre i casi rende il programma meno chiaro e può lasciarlo scorretto.
La scelta fra thread di piattaforma e virtuali arriva dopo aver identificato la natura del lavoro. Per poche attività lunghe che impegnano la CPU, un numero controllato di lavoratori può essere ragionevole. Per molte attività che aspettano I/O, i thread virtuali offrono uno stile semplice. In entrambi i casi, la condivisione dei dati mantiene le stesse regole. Il numero di thread non può essere il primo parametro da ottimizzare se non abbiamo ancora stabilito che cosa significhi «risultato corretto» e quando l'operazione deve terminare.
Per verificare la comprensione. Si prenda il programma del deposito e si descrivano due esecuzioni: una in cui il consumatore entra per primo, una in cui entra per primo il produttore. In entrambe si deve poter giustificare la stampa dei cinque valori. Poi si immagini un secondo consumatore e si spieghi perché il
whileresta indispensabile e perché occorre una seconda sentinella. Infine si scelga se un contatore di ordini completati richiede soltanto un numero atomico o una modifica coordinata con lo stato degli ordini. La risposta deve citare l'invariante che si vuole mantenere.
Errori che una stampa ordinata può nascondere
È possibile che un programma con una race condition produca righe ordinate e rassicuranti. Nel caso del conto, per esempio, i due prelievi possono apparire uno dopo l'altro nella console pur avendo entrambi letto il saldo prima della stampa. La console è una risorsa con proprie regole di sincronizzazione; il fatto che due messaggi non si sovrappongano carattere per carattere non dimostra che le operazioni di dominio siano state coordinate. Per valutare il programma occorre identificare le letture e le scritture del saldo, il lock che le protegge e il punto in cui l'esito viene deciso.
Un altro errore frequente consiste nell'usare una collezione ordinaria da più thread perché ogni thread «tocca elementi diversi». Se i thread modificano la struttura della collezione, per esempio aggiungendo a una ArrayList, possono interferire sulla dimensione, sull'array interno e sugli indici anche quando gli oggetti aggiunti sono distinti. La scelta corretta può essere una collezione concorrente, un lock intorno alla modifica o la raccolta di risultati locali da unire dopo join. Il punto è capire che cosa è condiviso: non basta che i dati logici sembrino diversi se il contenitore fisico è lo stesso.
Il caso opposto è condividere soltanto oggetti immutabili. Se un thread costruisce un record con dati finali, lo consegna attraverso una BlockingQueue e un altro lo legge, il consumatore non deve coordinare modifiche interne che non esistono. Deve comunque ricevere l'oggetto tramite un canale con le necessarie garanzie di pubblicazione. La coda offre questo passaggio secondo il proprio contratto. L'immutabilità riduce il numero di invarianti da proteggere, ma non cancella la necessità di definire come e quando il riferimento passa da un thread all'altro.
Approfondimento – Pubblicazione sicura. Un oggetto può essere costruito da un thread e reso visibile a un altro. Le regole del Java Memory Model stabiliscono quando il secondo thread vede correttamente gli effetti della costruzione e delle scritture precedenti. Una coda concorrente, un monitor usato correttamente o la conclusione osservata con
joinforniscono relazioni utili. Passare il riferimento attraverso un campo ordinario scritto e letto senza protocollo può essere una data race. Non si risolve perché l'oggetto «è stato creato prima» secondo l'orologio della parete.
Dal ciclo infinito alla chiusura esplicita
Molti esempi introduttivi usano while (true) perché rende evidente il lavoro ripetuto. In un servizio vero occorre rispondere a una domanda ulteriore: chi decide quando fermarsi? Un thread che legge da una coda può ricevere una sentinella; uno che aspetta I/O può essere interrotto; un esecutore può essere chiuso e attendere i lavori già accettati. La scelta deve essere compatibile con le risorse in uso. Se il thread possiede uno stream, una connessione o un file, la terminazione deve condurre anche alla chiusura di quella risorsa.
La sentinella dell'esempio ha una proprietà comoda: viaggia nello stesso canale dei dati. Arriva dopo i cinque numeri inseriti dal singolo produttore, quindi il consumatore non può incontrarla prima dei valori precedenti. Con più produttori, però, uno potrebbe inserire la sentinella mentre un altro ha ancora dati da produrre. Serve un coordinatore che sappia quando tutti i produttori hanno finito, oppure un protocollo più ricco. Ancora una volta, il meccanismo put/take è corretto, ma il significato dell'ultimo elemento dipende dall'organizzazione del lavoro.
L'interruzione è una forma di richiesta che non viaggia nella coda. Può svegliare un thread da take, ma non descrive di per sé se i dati rimasti vadano completati, restituiti a un altro lavoratore o scartati. Una strategia può essere «termina appena possibile»; un'altra «completa l'elemento già preso e poi termina». Entrambe possono essere legittime, ma vanno rese esplicite. Per questo catch (InterruptedException e) {} non è soltanto una cattiva abitudine stilistica: elimina l'informazione che il sistema usa per gestire la durata dell'attività.
Nel codice di esempio il catch ripristina il segnale e lascia terminare la lambda. La forma è adatta alla prova normale, in cui nessun thread viene interrotto prima della sentinella. Se volessimo provare la cancellazione a metà produzione, dovremmo aggiungere un percorso che svegli e concluda anche il consumatore. Un test che interrompe il produttore e poi aspetta indefinitamente il consumatore rivelerebbe un difetto del protocollo di chiusura, non della coda. Tenere separati trasferimento dei dati e politica di terminazione rende questo difetto più facile da vedere.
Il costo nascosto dell'attesa attiva
Nel segnale volatile il lavoratore esegue un ciclo che controlla ripetutamente il campo fermati. Questo è busy waiting, o attesa attiva: mentre attende, il thread continua a occupare tempo di elaborazione. Thread.onSpinWait() può aiutare la piattaforma a ottimizzare un ciclo di spin molto breve, ma non trasforma l'attesa in un blocco senza costo. Per una richiesta che può arrivare dopo secondi o minuti, conviene scegliere un'attesa bloccante o un meccanismo di notifica. L'esempio resta utile perché isola la visibilità senza confonderla con altri strumenti.
Aggiungere Thread.sleep(1) al ciclo ridurrebbe il numero di controlli, ma introdurrebbe una latenza arbitraria e non renderebbe corretta una versione non volatile. La specifica chiarisce che sleep non è una barriera di sincronizzazione. Il thread potrebbe ancora non avere una relazione che obblighi a osservare la scrittura dell'altro. Se il requisito è «svegliati quando arriva un evento», la forma appropriata è una primitive di coordinamento, non un sondaggio temporizzato scelto per tentativi.
Questo esempio permette di separare due tipi di efficienza. Un thread bloccato non consuma continuamente CPU per chiedere se la condizione è cambiata; un thread in spin può reagire con poca latenza se l'attesa è davvero brevissima e il sistema ha risorse disponibili. La scelta richiede misure e conoscenza del carico. In un manuale di base non serve trasformare l'eccezione di micro-ottimizzazione in consiglio generale: prima si scrive un protocollo corretto, poi si misura se il costo d'attesa è un problema reale.
Mettere alla prova una spiegazione di concorrenza
Una buona spiegazione deve poter rispondere a quattro domande. Quale stato è condiviso? Quali thread lo leggono o lo scrivono? Quale regola deve rimanere vera? Quale evento autorizza ciascun thread a proseguire? Nel deposito, lo stato è prodotto; produttore e consumatore lo modificano sotto lo stesso monitor; il posto non può essere contemporaneamente vuoto e pieno; i while attendono la condizione necessaria. Nel contatore, lo stato è valore; i due lavoratori lo incrementano; ogni incremento deve contare una volta; il monitor serializza la sezione critica e join permette di leggere il totale finale.
Se una di queste risposte manca, una prova che «funziona sul mio computer» non colma il vuoto. Lo stesso vale per il codice di un libro. Un esempio che stampa due righe in un certo ordine deve spiegare quale istruzione o quale garanzia impone quell'ordine. Se non esiste, la didascalia deve chiamarlo output possibile, non output necessario. Questa disciplina è particolarmente importante quando il testo vuole insegnare a diagnosticare: il lettore deve imparare a distinguere una prova ripetibile da una fotografia di una singola esecuzione.
Una tecnica utile per l'autoverifica è cambiare deliberatamente la pianificazione senza cambiare il contratto: aggiungere lavoro locale a uno dei due thread, invertire l'ordine di start, usare thread virtuali al posto di quelli di piattaforma dove il programma lo consente. La proprietà finale deve restare vera se la sincronizzazione è corretta. Non è un test formale di tutti gli interleaving, ma costringe a formulare un'affermazione precisa. Se il programma passa solo quando un thread «arriva prima», la soluzione dipende dal caso e deve essere ripensata.
Collegare il capitolo al resto del libro
I thread eseguono metodi di classi ordinarie: valgono ancora incapsulamento, generics, eccezioni e contratti delle collezioni. Una BlockingQueue<Integer> usa i generics per dichiarare il tipo degli elementi; InterruptedException impone al chiamante una decisione di gestione; la lambda Runnable cattura riferimenti secondo le regole viste nella programmazione funzionale. La concorrenza non è un mondo separato in cui le regole precedenti scompaiono. Aggiunge una dimensione: più percorsi di esecuzione possono osservare e modificare lo stesso stato.
Questo collegamento spiega anche la preferenza per oggetti con responsabilità chiare. Se la classe DepositoConAttesa possiede il valore e il protocollo di attesa, chi la usa non deve sapere quando chiamare wait o su quale monitor sincronizzarsi. Se il protocollo fosse distribuito fra produttore e consumatore, ciascuno dovrebbe conoscere dettagli interni dell'altro e una modifica rischierebbe di rompere l'accordo. Un confine di classe ben scelto aiuta la correttezza concorrente oltre che la leggibilità.
Infine, il passaggio al capitolo sui classloader ricorda che la JVM gestisce sia attività sia definizioni di tipi durante l'esecuzione. Un thread può richiedere per la prima volta una classe mentre un altro thread sta lavorando; i meccanismi di caricamento hanno proprie garanzie di coordinamento. Non dobbiamo implementarle nei nostri esempi di contatore, ma dobbiamo evitare una conclusione sbagliata: la presenza di più thread non rende la JVM priva di regole. Il nostro compito è rispettare i contratti che le API e il linguaggio definiscono, non assumere un ordine che nessuno ha promesso.
Una traccia finale da saper raccontare
Per controllare di aver capito il capitolo, immaginiamo che main crei una coda con due posti, avvii un produttore e un consumatore virtuali e attenda entrambi. Il produttore inserisce 0 e 1; a quel punto la coda potrebbe essere piena oppure il consumatore potrebbe aver già preso un valore. Se è piena, put(2) attende. Quando il consumatore esegue take(), libera un posto e permette al produttore di avanzare. Nessuna di queste possibilità cambia l'ordine dei valori che il singolo consumatore riceve dalla coda. Dopo 4 arriva la sentinella, che fa uscire il consumatore. Le due join assicurano che main non dichiari finito il programma dimostrativo prima dei lavoratori.
La stessa traccia, letta con il deposito manuale, richiede di citare il monitor e i due while. Se il consumatore arriva prima, wait rilascia il monitor; il produttore può inserire 0; notifyAll permette al consumatore di tornare candidato; il consumatore riacquisisce il monitor e controlla la condizione. Se il produttore arriva prima, il consumatore trova il valore senza attendere. Una spiegazione che funziona solo per il primo caso non ha ancora descritto il protocollo: ha descritto una sola possibile sequenza di eventi.
Infine, se qualcuno propone di sostituire tutto con Thread.sleep(100) dopo start, chiediamo quale contratto garantisca che cento millisecondi bastino, che il valore sia visibile e che l'operazione sia completa. Non c'è una risposta basata soltanto su sleep. Il percorso del capitolo conduce proprio qui: definire la proprietà, scegliere lo strumento che la garantisce, verificare l'esito senza trasformare lo scheduler in un oracolo.
Domanda di controllo – Perché non basta una prova riuscita? Un programma con
valore++non protetto può stampare il totale atteso anche molte volte di seguito. Quel risultato significa soltanto che le intercalazioni osservate non hanno reso visibile la perdita, oppure che il difetto non è emerso in quelle condizioni. Il contratto del linguaggio non promette l'atomicità dell'espressione. La prova di correttezza passa dal protocollo usato da tutti i thread: monitor comune o operazione atomica appropriata. Dopo averlo stabilito, i test verificano che l'implementazione e la gestione della durata rispettino il protocollo. Le due forme di evidenza si completano: una spiegazione teorica senza esecuzione può nascondere un errore nel codice, mentre un'esecuzione riuscita senza modello può nascondere una race condition.
Nel capitolo 20A sulle operazioni atomiche partiamo dal contatore di queste pagine e cambiamo domanda: che cosa accade quando l'incremento o il decremento deve anche decidere se una richiesta può essere accettata? Il caso delle ultime copie disponibili porta a compareAndSet; una statistica molto aggiornata porta invece a valutare LongAdder. Il criterio resta quello costruito qui: prima si identifica l'invariante, poi si sceglie il confine che la protegge.
Un secondo controllo riguarda il significato di «terminato». Un thread può aver concluso il proprio run, ma il programma può ancora dover leggere un risultato, chiudere una risorsa o comunicare un errore al chiamante. join attende il thread; Future.get attende e riporta anche il risultato o il fallimento dell'attività. La scelta dipende dall'informazione che il chiamante deve ricevere. Questa è la ragione per cui i due esempi finali del capitolo usano strumenti diversi pur potendo entrambi eseguire un calcolo in un altro thread.