Il catalogo non abita più nello stesso programma
Il catalogo della biblioteca può essere gestito da un servizio remoto. Finché i libri erano in una Map locale, cercare un codice significava eseguire un metodo nello stesso processo. Attraverso la rete compaiono nuove possibilità: il server può non rispondere, la risposta può arrivare lentamente, un intermediario può restituire un errore e il testo ricevuto può non avere il formato atteso. La domanda del capitolo è come ottenere un dato senza confondere «nessun libro» con «non sono riuscito a chiedere».
Un host è un nodo raggiungibile tramite un nome o un indirizzo; il DNS può tradurre un nome in un indirizzo di rete. Una porta distingue servizi sul nodo. TCP fornisce un flusso ordinato di byte fra due estremità; UDP trasporta datagrammi e non promette da solo consegna, ordine o assenza di duplicati. HTTP è un protocollo applicativo sopra un trasporto: definisce richieste, risposte, metodi, status e header. Il corpo di una risposta può essere testo, byte di un'immagine o un formato come JSON. La figura 27.1 separa questi livelli, perché un errore DNS, un timeout TCP, un codice HTTP 404 e un JSON malformato richiedono diagnosi diverse.
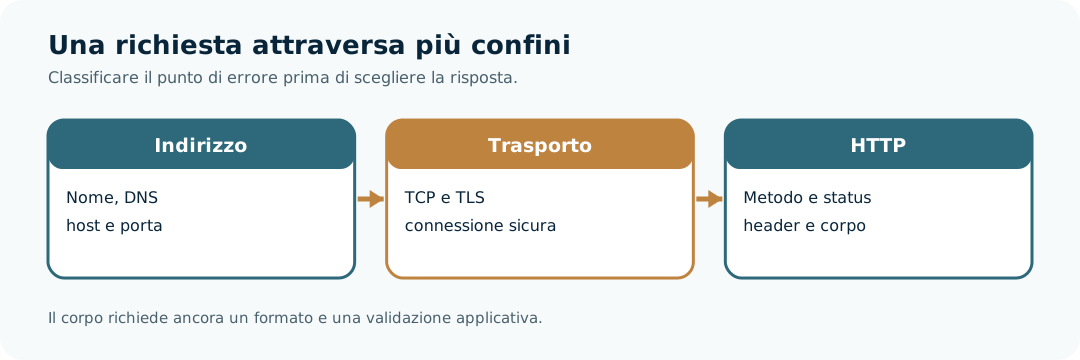
Un URI identifica una risorsa con uno schema e altre parti, per esempio https://esempio.invalid/libri/42. Un URL è una forma di riferimento che indica anche un meccanismo di accesso, ma nel client moderno partiamo dalla rappresentazione URI. Non costruiamo componenti arbitrari concatenando stringhe fornite da un utente: spazi, ?, #, slash e caratteri non ASCII hanno significati o regole di codifica. Una query va costruita codificando i valori dei parametri secondo il contratto del servizio, senza applicare una codifica indistinta all'intero URI. La risoluzione di un riferimento relativo con URI.resolve è un'operazione semantica, non una semplice giustapposizione di testo.
Per esempio, la chiave libro Java & Reti non può essere aggiunta senza preparazione a ...?titolo=. Il carattere & separerebbe parametri, cambiando la domanda inviata al server. Al contrario, codificare un URI completo come un unico valore trasformerebbe anche i suoi delimitatori. Prima si determina in quale componente deve entrare il dato, poi si applicano le regole di codifica di quel componente. La rappresentazione testuale finale si può stampare in un test, evitando però di registrare query che contengono credenziali o dati personali.
Un primo socket e il suo limite
Un Socket TCP collega il processo a host e porta e offre flussi di ingresso e uscita, che abbiamo imparato a gestire nel capitolo 25. Se inventiamo un protocollo a righe, dobbiamo stabilire dove finisce una richiesta, quale charset si usa, come si distinguono un errore e un valore e che cosa succede se il peer chiude a metà. Il socket non interpreta HTTP per noi. DatagramSocket per UDP è adatto ad altri protocolli, ma la sua assenza di connessione non significa automaticamente «più veloce per qualunque servizio». Per un catalogo HTTP useremo l'API che esprime già richieste e risposte HTTP.
Client, richiesta, risposta
HttpClient è l'oggetto configurato che può servire più richieste e riusare risorse come le connessioni. Un HttpRequest descrive una richiesta specifica: URI, metodo, header, corpo eventuale e timeout. HttpResponse<T> contiene status, header e un corpo di tipo T determinato dal BodyHandler scelto. La scelta di BodyHandlers.ofString(StandardCharsets.UTF_8) dichiara che il corpo va letto come testo UTF-8; ofByteArray conserva i byte, ofFile scrive su file e ofInputStream lascia al chiamante uno stream da consumare o chiudere. Queste forme non cambiano il significato del codice HTTP.
GET chiede una rappresentazione della risorsa; una richiesta con corpo usa un BodyPublisher, per esempio BodyPublishers.ofString quando il protocollo applicativo accetta testo. L'header Content-Type descrive il formato mandato o ricevuto, ma non convalida automaticamente il corpo. Se il server dichiara JSON e invia testo non valido, il trasporto può aver funzionato perfettamente mentre l'interpretazione applicativa fallisce. Il client dovrebbe preservare in diagnosi almeno URI senza segreti, metodo, status e causa del parsing; registrare indiscriminatamente l'intero corpo può invece esporre dati riservati o saturare i log.
Nel programma completo avviamo un piccolo server soltanto sull'indirizzo di loopback della macchina, chiediamo /libri e stampiamo risposta e corpo. Il server didattico usa jdk.httpserver, un modulo del JDK distinto dalla specifica Java SE generale e non un framework per un server di produzione. Si compila con javac --release 25 --add-modules jdk.httpserver ClientLocale.java e si esegue con java --add-modules jdk.httpserver ClientLocale. La porta 0 fa scegliere al sistema una porta libera: non occorre fissare una porta che potrebbe essere occupata. Il client è chiuso al termine del try, il server nel finally.
import com.sun.net.httpserver.HttpServer;
import java.io.IOException;
import java.net.InetAddress;
import java.net.InetSocketAddress;
import java.net.URI;
import java.net.http.HttpClient;
import java.net.http.HttpRequest;
import java.net.http.HttpResponse;
import java.nio.charset.StandardCharsets;
import java.time.Duration;

public class ClientLocale {
    public static void main(String[] args) throws IOException, InterruptedException {
        HttpServer server = HttpServer.create(
                new InetSocketAddress(InetAddress.getByName("127.0.0.1"), 0), 0);
        server.createContext("/libri", scambio -> {
            byte[] corpo = "libro=Java".getBytes(StandardCharsets.UTF_8);
            scambio.getResponseHeaders().set("Content-Type", "text/plain; charset=utf-8");
            scambio.sendResponseHeaders(200, corpo.length);
            try (var uscita = scambio.getResponseBody()) {
                uscita.write(corpo);
            }
        });
        server.start();
        try (HttpClient client = HttpClient.newBuilder()
                .connectTimeout(Duration.ofSeconds(2)).build()) {
            URI uri = URI.create("http://127.0.0.1:" + server.getAddress().getPort()
                    + "/libri");
            HttpRequest richiesta = HttpRequest.newBuilder(uri)
                    .timeout(Duration.ofSeconds(3)).GET().build();
            HttpResponse<String> risposta = client.send(richiesta,
                    HttpResponse.BodyHandlers.ofString(StandardCharsets.UTF_8));
            System.out.println("HTTP " + risposta.statusCode());
            System.out.println(risposta.body());
        } finally {
            server.stop(0);
        }
    }
}
L'output atteso è HTTP 200 seguito da libro=Java. Il corpo non viene letto direttamente dallo stream del socket: il BodyHandler lo converte nel tipo richiesto. Se il servizio rispondesse 404, send restituirebbe comunque una risposta HTTP da esaminare; uno status non è di per sé una IOException. Se invece il nome host non si risolve o la connessione fallisce, non c'è una risposta HTTP da interpretare. Questa distinzione impedisce di trasformare ogni guasto in Optional.empty() come se il libro semplicemente non esistesse.
Concetto chiave – Uno status è un fatto del protocollo. Il server può rispondere
200con un corpo inatteso,404per risorsa assente,429per un limite di richieste o503per indisponibilità temporanea. Il programma deve leggere il contratto del servizio e decidere quali status sono risultati normali e quali richiedono gestione dell'errore. Il metodoBodyHandlers.ofStringnon rifiuta automaticamente i corpi degli status non riusciti.
La configurazione di HttpClient comprende una preferenza per HTTP/1.1 o HTTP/2, redirect, proxy e autenticazione. Si configura ciò che serve al sistema; una preferenza di versione non garantisce che il peer userà proprio quella versione. Il timeout di connessione riguarda la fase in cui si stabilisce il collegamento, mentre HttpRequest.timeout limita la durata dell'operazione di risposta secondo il contratto dell'API. Sono limiti diversi. Un timeout di dieci secondi non prova che il server non abbia elaborato una richiesta: il client può perdere la risposta dopo che il server ha già compiuto il lavoro.
Attese, errori e retry
send attende il risultato e può lanciare IOException o InterruptedException. Se il thread viene interrotto, il chiamante deve rispettare la politica di interruzione del proprio contesto; un metodo che cattura l'eccezione senza poterla rilanciare dovrebbe almeno ripristinare il flag. sendAsync restituisce un CompletableFuture<HttpResponse<T>>: permette di comporre lavoro asincrono e fa emergere il fallimento tramite il completamento eccezionale. Non trasforma la rete in un'operazione immediata né esonera dal consumare correttamente un corpo a flusso. Nel capitolo 20 abbiamo visto che un thread virtuale consente di mantenere codice bloccante lineare mentre molte richieste aspettano I/O; resta necessario limitare richieste concorrenti, memoria e capacità del servizio remoto. La figura 27.2 mostra che la decisione di riprovare viene dopo la classificazione del fallimento.
Il capitolo 20A ha mostrato che un CAS locale può far riuscire una sola prenotazione nella memoria della JVM. Se la prenotazione diventa una richiesta HTTP verso un archivio remoto, quel CAS non governa lo stato del server. Dopo un timeout il client potrebbe non sapere se il server abbia completato l'operazione: ritentare senza un contratto di idempotenza o una chiave di richiesta concordata può duplicarla. La garanzia va costruita nel protocollo e nell'archivio che riceve la richiesta.

Ripetere una richiesta può essere utile dopo un errore temporaneo, ma non è una cura generale. Un'operazione idempotente produce lo stesso effetto desiderato se ripetuta nelle stesse condizioni; ciò non significa che ogni tentativo abbia identici log o tempi. Una GET che interroga dati è spesso ripetibile secondo il contratto HTTP, mentre un POST che crea una fattura può duplicare un effetto se il client non ha ricevuto la prima risposta. Anche quando il metodo è teoricamente idempotente, l'implementazione concreta del servizio conta. Un retry ha un numero massimo di tentativi, attese controllate, eventualmente jitter per evitare sincronizzazione dei client, e un criterio sugli status e sugli errori. Deve essere osservabile; un ciclo infinito che nasconde l'errore aumenta il carico proprio quando il servizio è in difficoltà.
Con jitter intendiamo una piccola variazione casuale dell'attesa fra tentativi. Se mille client attendono tutti esattamente un secondo dopo un 503, possono tornare insieme e sovraccaricare di nuovo il server; distribuire le attese riduce questa concentrazione. La variazione deve rispettare un limite e non sostituisce il numero massimo di tentativi. Se il server comunica un tempo di attesa con un header come Retry-After, il contratto HTTP e quello del servizio guidano la decisione. Un retry automatico deve anche poter essere annullato quando il chiamante non è più interessato al risultato.
Una cancellazione di CompletableFuture può interrompere il lavoro in corso in modo dipendente dall'implementazione e dal punto dell'operazione. Non equivale a «il server non ha eseguito». Per una modifica remota occorre un protocollo che permetta di correlare tentativi, per esempio una chiave di idempotenza quando il servizio la supporta. La gestione di un timeout deve conservare questa incertezza, anziché dichiarare un fallimento della modifica senza prove.
HTTPS e identità del peer
HTTPS usa TLS per proteggere il trasporto e verificare l'identità del peer secondo la configurazione di fiducia. Un certificato non fidato è un segnale da diagnosticare, non un invito a disabilitare tutte le verifiche. L'applicazione deve sapere da dove proviene il materiale di fiducia e come vengono aggiornate le credenziali. Un Authenticator e un CookieHandler possono far parte della configurazione del client; per protocolli di identità più complessi serve un contratto specifico. Le password non vanno inserite nell'URI, nei log o negli esempi distribuiti.
Se il server presenta un certificato valido per un nome diverso dall'host richiesto, il problema non riguarda il parsing del corpo né il codice HTTP: il client non ha ancora una risposta applicativa affidabile. Un sistema che usa una propria autorità di certificazione deve distribuirne la fiducia con un processo controllato; accettare qualunque certificato rende inutile la verifica dell'identità. L'autenticazione dell'utente è una domanda successiva e diversa: un canale HTTPS può essere protetto anche quando la richiesta non contiene ancora credenziali applicative.
Il formato e la dimensione del corpo
Il corpo è un secondo confine. Il nostro server restituisce testo semplice libro=Java; se restituisse JSON, HttpClient consegnerebbe stringhe o byte, non un oggetto del dominio già validato. Java SE non impone un parser JSON generale. Serve una libreria dichiarata, una grammatica e una validazione dei campi. Prima di scrivere una risposta su disco, definiamo anche un limite di dimensione: ofString e ofByteArray portano il corpo in memoria. Per contenuti grandi scegliamo un handler a file o a flusso, gestendo chiusura e pubblicazione come nel capitolo 25.
Il metodo ofFile è comodo quando il corpo può essere scritto direttamente nella destinazione scelta. Se il file rappresenta un archivio che altri processi leggono, la comodità non sostituisce la pubblicazione controllata: si può scaricare in un file provvisorio, convalidarne dimensione e contenuto, poi decidere se sostituire il file visibile. Questo è lo stesso mattone del capitolo 25 applicato a un'origine remota. Se la risposta viene consumata con ofInputStream, la chiusura del flusso è responsabilità del chiamante; lasciarlo aperto può impedire il rilascio delle risorse e ritardare la chiusura ordinata del client.
Quando servono messaggi continui
WebSocket mantiene uno scambio di messaggi in entrambe le direzioni dopo un'apertura specifica. Un listener riceve eventi e deve rispettare la richiesta dei messaggi successivi e la pressione del consumatore; non è una variante con un nome diverso di HttpClient.send. È adatto quando il problema richiede aggiornamenti continui, per esempio lo stato in tempo reale di un catalogo, e comporta un protocollo di applicazione per connessione, riconnessione e chiusura.
Se la schermata chiede soltanto il titolo di un libro quando l'utente preme «Cerca», la richiesta HTTP ordinaria ha un inizio e una fine naturali. Se invece la schermata deve ricevere un flusso di cambiamenti del catalogo, un WebSocket può evitare interrogazioni ripetute; occorre però definire che cosa fare dopo una disconnessione. Il server invierà una fotografia completa, oppure eventi dal numero progressivo successivo all'ultimo ricevuto? Senza questa regola, una riconnessione può mostrare un catalogo incoerente anche se il canale di trasporto funziona.
Trasferire la soluzione al servizio reale
Il server locale garantisce un caso positivo controllato. Modifichiamolo prima per rispondere 404, poi 503 una sola volta e infine 200. Il client deve distinguere «libro assente» da «servizio temporaneamente indisponibile» e riprovare soltanto se il contratto consente di ripetere la richiesta. Registriamo quante chiamate sono state fatte; un test che guarda solo il corpo finale non vede un ciclo di retry eccessivo. Un secondo esperimento ritarda la risposta oltre il timeout e verifica quale informazione il client possiede davvero sull'eventuale lavoro del server.
Infine chiediamo a dieci thread virtuali di interrogare il servizio con un limite di tre richieste simultanee. Il punto non è dimostrare che dieci sia un numero magico: è mostrare che il modello di concorrenza del client e la capacità del peer sono limiti diversi. Il lettore ha trasferito il mattone quando sa scegliere fra send, sendAsync e un thread virtuale per il proprio programma, e sa spiegare quali errori restano possibili in ciascun modello.
Riferimenti essenziali. La specifica Java 25 di
HttpClientdescrive riuso, risorse e chiusura; la specifica deiBodyHandlerschiarisce che gli handler predefiniti non esaminano lo status. La politica di retry e la forma del corpo dipendono dal contratto del servizio, non dall'API del client.