Dalla collezione al calcolo
Nel capitolo precedente abbiamo conservato in una lista i numeri 1, 2, 3, 4, 5, 6, 3. Ora vogliamo una nuova lista senza i valori uguali a 3. Possiamo scrivere un ciclo, controllare ogni numero e aggiungere quelli ammessi a una lista nuova. La Stream API offre un'altra forma per descrivere quel calcolo: dati.stream().filter(numero -> numero != 3).toList(). filter esprime la condizione, toList produce il risultato. Il ciclo resta una soluzione valida; lo stream è utile quando la sequenza di trasformazioni rende più leggibile l'intenzione.
Uno stream non richiede al lettore di partire da concetti come le monadi e non promette, da solo, lavoro asincrono o maggiore velocità. Uno stream Java è una vista di elaborazione su una sorgente di elementi, con operazioni aggregate che possono essere composte. Non è, di per sé, una struttura che contiene gli elementi come una lista; non è automaticamente asincrono; una pipeline sequenziale lavora normalmente nel thread chiamante. Il parallelismo è una scelta distinta, con costi e vincoli propri.
Definizione – Pipeline. Una pipeline comprende una sorgente, zero o più operazioni intermedie e un'operazione terminale. La sorgente può essere una collezione, un array, un generatore o una risorsa come un file. Le operazioni intermedie descrivono trasformazioni; quella terminale richiede un risultato o un effetto e consuma lo stream. Dopo il consumo, lo stesso stream non è riutilizzabile.
Nel programma completo, dati.stream() crea uno stream dalla lista, filter descrive gli elementi da mantenere e toList() produce [1, 2, 4, 5, 6]. La seconda stampa mostra ancora [1, 2, 3, 4, 5, 6, 3]: la pipeline non ha modificato la lista sorgente. Stream.toList() restituisce una lista non modificabile. Se vogliamo una nuova ArrayList modificabile, la costruiremo esplicitamente dal risultato o useremo un collector appropriato.
La figura 18.1 fa vedere l'ordine logico dei passaggi. Non va letta come promessa che ogni passaggio venga completato su tutti gli elementi prima di iniziare il successivo: l'implementazione può attraversare la pipeline elemento per elemento e, quando è lecito, evitare lavoro non necessario.

filter, la terminale toList materializza una nuova lista. Lo stream descrive l'elaborazione; la lista finale è un oggetto distinto dalla sorgente.Dal ciclo alla pipeline, senza perdere il controllo
Riprendiamo il problema che apre il capitolo: eliminare dalla nuova lista tutti i valori uguali a 3. Nel ciclo for che segue vediamo tre operazioni: attraversare la sorgente, decidere se un elemento passa e aggiungerlo al risultato. La pipeline filter(...).toList() conserva le stesse tre responsabilità, ma affida l’attraversamento all’API. L’iterazione continua a esistere: il nostro codice descrive la condizione e la forma del risultato, mentre la libreria gestisce il percorso. Confrontiamo quindi i due risultati sugli stessi dati prima di scegliere la forma più leggibile. Lo stream è utile quando il calcolo si legge come una sequenza di trasformazioni; se ogni elemento richiede molti rami di errore con effetti diversi, un ciclo esplicito può rendere più facile seguire e verificare il lavoro.
List<Integer> origine = List.of(1, 2, 3, 4, 5, 6, 3);
List<Integer> copia = new ArrayList<>();
for (int valore : origine) {
    if (valore != 3) copia.add(valore);
}
List<Integer> filtrati = origine.stream()
        .filter(valore -> valore != 3)
        .toList();
I due risultati hanno gli stessi elementi [1, 2, 4, 5, 6], ma non lo stesso contratto di modificabilità: copia è una ArrayList che possiamo modificare, mentre la lista restituita da Stream.toList() è non modificabile. La sorgente origine resta [1, 2, 3, 4, 5, 6, 3] in entrambi i casi. Questa verifica impedisce di scambiare una somiglianza di output per identità completa di comportamento. Se il risultato deve essere una lista mutabile, lo dichiariamo e la costruiamo; se non deve cambiare, la lista di toList rende utile quel vincolo.
Una terza versione con origine.forEach(x -> { if (...) copia.add(x); }) usa una lambda ma conserva l'accumulatore esterno. Su un ciclo sequenziale piccolo può funzionare; non offre il vantaggio di un risultato espresso dalla pipeline e diventa pericolosa se qualcuno sostituisce la sorgente con un parallel stream. La presenza di una lambda non basta a rendere il codice “funzionale”. È la relazione fra input, trasformazioni ed effetti a stabilire se il modello è adatto.
Sorgente, passaggi intermedi, terminale
Una pipeline inizia da una sorgente. origine.stream() produce uno stream associato alla lista. filter è un'operazione intermedia: definisce quali elementi potranno proseguire e restituisce un altro stream. toList è terminale: richiede l'elaborazione e restituisce una lista. Anche count, sum, findFirst, anyMatch, collect e forEach sono terminali, ma non producono tutti lo stesso tipo di risultato. Alcune restituiscono un valore, altre un Optional, altre un effetto. Prima di scegliere la terminale, formuliamo la domanda: vogliamo tutti gli elementi, il primo, un conteggio, una somma o una stampa?
La distinzione non è una convenzione grafica. Una catena che termina con filter ha soltanto descritto un lavoro; se non viene consumata, non produce la lista filtrata. Una catena che chiama count ha consumato lo stream: lo stesso oggetto non può essere riattraversato con toList. Possiamo invece chiedere alla lista sorgente un nuovo stream() per una seconda domanda. Questa caratteristica è simile a un Iterator che, una volta avanzato fino alla fine, non torna automaticamente all'inizio. Non dobbiamo confondere la consumazione della pipeline con la chiusura automatica di una risorsa esterna: uno stream di file richiede ancora la gestione del file.
Box – La pigrizia non è una promessa di chiamate. L'API garantisce il risultato della pipeline secondo il contratto delle operazioni, non che una lambda intermedia venga invocata esattamente una volta per ogni elemento in ogni caso. Un'implementazione può evitare lavoro inutile. Per questo
map(x -> { registra(x); return x; }).count()è un posto sbagliato per un'azione necessaria comeregistra. Se l'azione deve avvenire, rendiamola esplicita e controlliamo il suo ciclo di vita; se vogliamo soltanto contare, usiamocountsenza effetto nascosto.
Costruire stream da sorgenti diverse
La List è la sorgente più familiare, ma uno stream può arrivare da un array, da valori dichiarati nel codice, da un generatore o da un file. Stream.of("rosso", "blu") è pratico per pochi valori noti; Stream.<String>empty() rappresenta nessun elemento. Stream.ofNullable(valore) produce zero elementi quando il valore è null e uno quando è presente. Non va confuso con Stream.of(valore): nel caso di un singolo riferimento null, l'overload e il significato desiderato possono essere ambigui per il lettore; scegliere ofNullable rende esplicita l'assenza.
Stream.builder() permette di aggiungere valori uno alla volta prima di costruire lo stream. È utile quando gli elementi vengono selezionati durante una breve preparazione; dopo build, il builder non è un contenitore da continuare a modificare. Per dati già dentro una collezione, creare un builder e copiare ogni valore aggiunge lavoro senza beneficio. Arrays.stream(array) usa un array esistente; con int[] produce IntStream, con String[] produce Stream<String>. Lo stesso nome del metodo nasconde overload adatti ai diversi tipi, perciò leggiamo sempre il tipo di ritorno che il compilatore ha scelto.
Un testo separato da virgole può essere letto con Pattern.compile(",").splitAsStream(testo). Qui il separatore è una espressione regolare. La virgola semplice non richiede escape, ma un punto significherebbe “qualunque carattere” se non fosse protetto. Dopo la divisione possiamo applicare map(String::strip) e filter(s -> !s.isEmpty()) per pulire gli elementi. Una pipeline non convalida automaticamente il contenuto: se una voce è malformata, serve una regola di dominio e una decisione sull'errore.
Stream.generate(supplier) chiede nuovi elementi al supplier ogni volta che servono. Senza un limite può produrre una sequenza senza fine. Stream.iterate(seme, passo) costruisce il primo valore dal seme e i successivi applicando il passo al precedente. La forma con predicato Stream.iterate(seme, continua, passo) ferma la sequenza quando la condizione non è più vera. Nel programma completo DemoCatalogoStream.java, Stream.iterate(2, n -> n <= 8, n -> n + 2).toList() produce [2, 4, 6, 8]: il valore 2 è il seme, n <= 8 decide se emetterlo, n + 2 prepara il successivo. L'ordine dei tre argomenti non è arbitrario; segue la domanda “da dove parto, quando continuo, come avanzo?”.
Una sorgente infinita richiede una terminale che possa fermarsi oppure un'operazione intermedia che la renda finita. Stream.generate(() -> "x").limit(3).toList() termina con tre valori; Stream.generate(() -> "x").toList() non ha un termine naturale e può esaurire le risorse. findFirst() può terminare anche senza limit, purché la ricerca sia in grado di trovare un elemento e le operazioni precedenti lo lascino passare. La presenza di una operazione di arresto anticipato non garantisce da sola che ogni pipeline finisca: se il predicato non è mai soddisfatto, la ricerca può continuare senza fine.
La valutazione è pigra
Molte operazioni intermedie sono lazy, cioè pigre: costruire dati.stream().filter(...) non attraversa immediatamente tutti i dati. Il lavoro richiesto avviene quando una terminale, come toList, count, findFirst o forEach, consuma la pipeline. Questo permette a operazioni di short circuit, o arresto anticipato, di non esaminare necessariamente tutta la sorgente. Per esempio, su uno stream ordinato, filter(...).findFirst() può fermarsi appena trova il primo elemento adatto.
La figura 18.2 separa il momento in cui prepariamo la pipeline da quello in cui chiediamo il risultato. Il caso di Anna è volutamente minimo: consente di verificare perché Andrea e Luca non devono necessariamente essere esaminati.
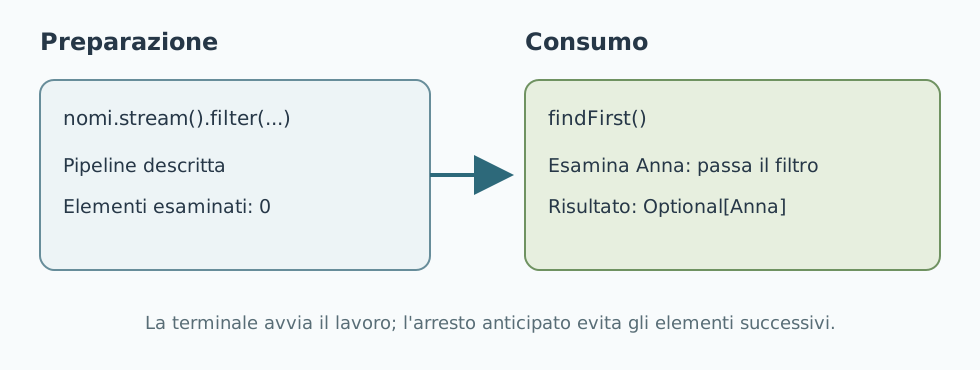
filter non visita i nomi; findFirst avvia la ricerca e può fermarla sul primo risultato.La pigrizia non autorizza a nascondere effetti in filter o map aspettandosi che vengano sempre eseguiti una volta per elemento. Alcune pipeline possono evitare o riorganizzare chiamate quando ciò non cambia il risultato richiesto dalla terminale. Un predicato dovrebbe descrivere una condizione, non registrare una fattura o incrementare un contatore necessario alla correttezza del programma. La documentazione Java 25 del package java.util.stream chiama non-interfering i comportamenti che non modificano la sorgente durante l'elaborazione e stateless quelli che non dipendono da uno stato variabile fra gli elementi.
Un oggetto Stream si usa per una sola pipeline consumata una volta. Se dobbiamo effettuare due calcoli sulla stessa collezione, possiamo creare due stream dalla collezione: dati.stream() a ogni calcolo. Conservare il riferimento allo stream e chiamare due terminali su di esso è un errore di ciclo di vita. L'eccezione che può comparire è una conseguenza, non il principio da memorizzare.
Osservare la pigrizia in esecuzione
Verifichiamo la distinzione appena introdotta senza usare una pausa artificiale. Prepariamo una lista di tre nomi e un filtro che stampa una riga diagnostica quando viene chiamato. Subito dopo aver costruito la pipeline, stampiamo preparata; poi invochiamo findFirst. L'output inizia da preparata, perché la semplice costruzione della pipeline non attraversa la lista. Solo la terminale mette in moto il lavoro. Se il primo nome soddisfa il predicato, la ricerca può fermarsi lì. La stampa nel predicato è uno strumento temporaneo per osservare l'esecuzione, non una parte della logica applicativa.
List<String> nomi = List.of("Anna", "Andrea", "Luca");
Stream<String> ricerca = nomi.stream().filter(nome -> {
    System.out.println("Esamino " + nome);
    return nome.startsWith("A");
});
System.out.println("Pipeline preparata");
String primo = ricerca.findFirst().orElse("nessuno");
System.out.println("Trovato " + primo);
Con questo ordine dei dati, ci aspettiamo prima Pipeline preparata, poi Esamino Anna, infine Trovato Anna. Il programma ci permette di associare il problema “trovare il primo nome adatto” alla soluzione filter più findFirst, alla verifica dell'arresto anticipato e al trasferimento verso una lista più grande. Se sostituiamo findFirst con toList, la terminale deve produrre tutti i nomi che passano e quindi attraversa anche gli elementi successivi. Se inseriamo sorted() prima di findFirst, l'operazione di ordinamento può dover conoscere tutti gli elementi prima di restituire il primo ordinato. La presenza di una terminale breve non cancella il costo delle operazioni precedenti.
L'ordine delle operazioni va ragionato con attenzione. Filtrare prima di una trasformazione costosa può risparmiare lavoro, se il filtro ha già le informazioni necessarie e le due operazioni possono essere spostate senza cambiare il significato. Se il filtro deve valutare il risultato della trasformazione, allora la trasformazione deve venire prima. Anche distinct e sorted possono cambiare quali elementi una limit vede: spostare limit(10) prima di sorted significa ordinare solo i primi dieci elementi incontrati, non scegliere i dieci minori dell'intera sorgente. Le regole di prestazione non sono permessi per modificare silenziosamente la risposta al problema.
Uno stream fresco per ogni domanda
Una lista di città può servire a rispondere prima “quante sono?” e poi “quale viene per prima in ordine alfabetico?”. Sono due terminali e richiedono due stream. La forma più semplice è chiamare citta.stream() due volte. Se la costruzione della sorgente è incapsulata in un metodo, possiamo usare Supplier<Stream<Citta>> e chiamare get() per avere una pipeline nuova a ogni domanda. Il supplier non rigenera necessariamente i dati: può restituire un nuovo stream sopra la stessa lista. Se invece apre un file a ogni chiamata, porta anche una responsabilità di chiusura e un costo I/O che non vanno nascosti.
Supplier<Stream<String>> sorgente = () -> nomi.stream();
long quanti = sorgente.get().count();
String primo = sorgente.get().sorted().findFirst().orElse("nessuno");
Questa soluzione è utile quando più funzioni ricevono la capacità di creare uno stream nuovo; nel codice ordinario, due chiamate dirette a nomi.stream() restano più immediate. Una pipeline non è una collezione da conservare per riuso. Il messaggio di errore stream has already been operated upon or closed segnala che abbiamo cercato di attraversare di nuovo un oggetto consumato; ricreare lo stream dalla sorgente è la risposta, purché la sorgente sia ancora disponibile e valida.
Trasformare, appiattire e interrompere
map trasforma ogni elemento in un altro valore. Da titoli possiamo ottenere lunghezze con map(String::length). Se la trasformazione di un elemento produce a sua volta più elementi, flatMap permette di appiattirli in un solo stream. Nel programma, le righe "Java,Reti" e "API" diventano [Java, Reti, API] attraverso flatMap(riga -> Stream.of(riga.split(","))). La trasformazione è visibile: prima dividiamo ogni riga, poi uniamo i piccoli stream risultanti.
mapMulti è un'altra forma per produrre zero o più risultati da un elemento mediante un consumatore fornito alla funzione. Può essere utile quando l'apertura di molti piccoli stream in flatMap renderebbe la pipeline meno adatta al problema, ma la scelta va fatta dopo aver verificato che il corpo resti leggibile. Stream.ofNullable(x) produce zero elementi se x è null, uno altrimenti; è utile per evitare un controllo separato in piccoli adattamenti, senza trasformare null in una scelta di modello sempre desiderabile.
Su una sorgente con ordine d'incontro, takeWhile conserva il prefisso finché il predicato è vero e si ferma al primo elemento che lo rende falso. dropWhile scarta quel prefisso e lascia il resto. Non sono sinonimi di filter, che valuta la condizione anche su elementi successivi. Stream.iterate(seme, predicato, passo) può generare una sequenza finita quando il predicato stabilisce quando fermarsi; se manca un limite, una terminale che richiede tutti gli elementi può non terminare. limit e skip sono altri strumenti di taglio, ma il loro costo dipende dall'ordine e dalla sorgente.
Gli stream primitivi come IntStream, LongStream e DoubleStream evitano il boxing di ogni elemento e offrono operazioni numeriche come sum e average. Non sempre conviene trasformare tutto in primitivi: se gli elementi hanno un significato di dominio, perdere il tipo dell'oggetto può rendere il codice meno chiaro. La scelta corretta unisce contratto, leggibilità e misurazione quando le prestazioni contano davvero.
Operazioni intermedie: seguire un elemento alla volta
filter mantiene o scarta un elemento secondo un Predicate. Su ["Roma", "Rovigo", "Bari"], il filtro citta -> citta.startsWith("R") produce le prime due città. map applica una Function a ciascun elemento che arriva: map(String::toUpperCase) cambia il testo, mentre map(String::length) cambia anche il tipo dello stream da Stream<String> a Stream<Integer>. Se vogliamo sommare le lunghezze, mapToInt(String::length).sum() esprime direttamente un calcolo numerico senza una lista intermedia di wrapper.
distinct elimina duplicati secondo la nozione di uguaglianza degli elementi. Per stringhe la distinzione è sensibile alle maiuscole: "Roma" e "ROMA" non sono uguali. Se vogliamo città distinte indipendentemente dalla grafia, dobbiamo decidere come normalizzarle, e map(String::toUpperCase).distinct() è una possibile soluzione. Ma normalizzare prima di conservare il nome originale significa anche perdere la grafia iniziale. Questo è un problema di modello, non un parametro nascosto di distinct.
sorted ordina gli elementi della pipeline. Per stringhe usa l'ordine naturale, che può non coincidere con un ordinamento linguistico locale; per oggetti di dominio serve un Comparator oppure un ordine naturale definito dalla classe. sorted(Comparator.comparing(Libro::titolo)) dice quale proprietà guida il confronto. Poiché per ordinare bisogna conoscere gli elementi da confrontare, sorted può richiedere di trattenere molti dati. Su una sorgente potenzialmente infinita, sorted().findFirst() non è un trucco innocuo per trovare il minimo: una riduzione min(comparatore) esprime meglio la richiesta e può lavorare senza ordinare tutti gli elementi.
skip(n) lascia cadere i primi n elementi, limit(n) non ne lascia passare più di n. Su una sorgente ordinata sono utili per una finestra di posizioni, ma non rappresentano automaticamente una paginazione stabile di dati che cambiano. Se nuovi elementi vengono inseriti all'inizio fra due richieste, la seconda pagina può ripetere o perdere valori. Qui il trasferimento dal piccolo esempio alla applicazione reale richiede un ordine stabile e un contratto sullo stato della sorgente. takeWhile e dropWhile lavorano invece su un prefisso definito da un predicato: dopo il primo elemento che interrompe il prefisso, non riprendono come farebbe un filtro generale.
flatMap entra in gioco quando un elemento della sorgente produce a sua volta una sequenza. Una lista di righe "Java,Reti", "API" diventa una lista di parole: map(riga -> riga.split(",")) darebbe uno stream di array, non ancora un unico flusso di parole; flatMap(riga -> Arrays.stream(riga.split(","))) unisce gli elementi dei piccoli stream in un flusso solo. La parola “appiattire” indica proprio il passaggio da un livello annidato a uno lineare. mapMulti permette di emettere zero o più elementi senza costruire esplicitamente uno stream per ogni ingresso; è utile soprattutto quando questa scelta semplifica un caso concreto, non per sostituire a priori ogni flatMap.
Le operazioni intermedie stateless, come i normali filter e map con funzioni senza stato, non devono ricordare elementi precedenti. Operazioni stateful come distinct e sorted hanno invece bisogno di informazione sull'insieme già visto o sull'insieme da ordinare. Questo spiega una differenza di costo che una lista di nomi di metodi non mostra. Una pipeline può essere pigra e tuttavia dover accumulare molti elementi quando arriva alla terminale. La pigrizia riguarda quando si lavora; la memoria necessaria dipende anche da quale operazione abbiamo richiesto.
Le terminali rispondono a domande diverse
Se chiediamo “quante città iniziano con R?”, filter(...).count() produce un long. Se chiediamo “ne esiste almeno una?”, anyMatch(...) produce un booleano e può fermarsi al primo successo. allMatch chiede se tutte soddisfano la condizione; noneMatch se nessuna la soddisfa. Su uno stream vuoto anyMatch è false, mentre allMatch e noneMatch sono true: nel caso di allMatch non esiste un controesempio, e nel caso di noneMatch non esiste un esempio che violi la condizione. Questa regola spesso sorprende, perciò va verificata con un piccolo programma prima di usarla in una validazione importante.
findFirst restituisce il primo elemento secondo l'ordine d'incontro, quando l'ordine esiste; findAny permette di scegliere un elemento qualsiasi. Entrambi restituiscono Optional<T> perché la sorgente o il filtro possono non produrre nulla. Il metodo orElse("nessuna città") rende esplicita la risposta in quel caso. min e max restituiscono anch'essi un Optional di oggetto: non c'è un minimo di una sequenza vuota. count, al contrario, ha un risultato definito, zero. Vedere il tipo di ritorno aiuta a riconoscere se l'assenza deve essere trattata.
forEach esegue un'azione, quindi serve quando l'effetto è proprio il risultato richiesto, per esempio inviare ogni riga a un consumer. Non restituisce una collezione. Per ottenere una lista, usiamo toList o collect; per ottenere un array tipizzato, toArray(String[]::new) fornisce una fabbrica della dimensione giusta. Collectors.joining(", ") concatena stringhe con un separatore; scegliere un separatore non aggiunge automaticamente regole di quoting o escape per un formato CSV. Se il risultato deve essere un vero file CSV, occorre gestire i campi che contengono virgole, virgolette e a capo.
Riduzione e raccolta, con un dominio concreto
Il programma DemoCatalogoStream.java usa quattro libri, ciascuno con titolo, reparto, numero di pagine e disponibilità. La prima domanda è “quali titoli disponibili mostro in ordine?”. Il programma filtra i disponibili, estrae i titoli, rimuove gli spazi ai bordi, ordina e produce una lista. Il risultato è [Algebra, Algoritmi, Java]. La sequenza dei metodi segue la domanda: prima selezioniamo libri, poi trasformiamo i libri in testi, poi puliamo e ordiniamo i testi. Se facessimo map(Libro::titolo) prima di filtrare sulla disponibilità, avremmo perso proprio la proprietà che serve al filtro.
La seconda domanda è “quanti libri ci sono in ciascun reparto?”. Collectors.groupingBy(Libro::reparto, Collectors.counting()) produce una mappa: la chiave è il reparto, il valore è il conteggio. perReparto.get("Informatica") vale 3. Un groupingBy semplice produrrebbe invece una mappa di liste di libri. Il collector a valle counting cambia il tipo del valore e evita di costruire liste quando vogliamo soltanto un numero. Il programma stampa solo la chiave che ci interessa: non facciamo dipendere una verifica dall'ordine di iterazione di una mappa per cui non abbiamo chiesto una garanzia d'ordine.
La terza domanda riguarda le pagine complessive. mapToInt(Libro::pagine) porta da oggetti Libro a valori primitivi int; summaryStatistics() calcola in una sola terminale conteggio, somma, minimo, massimo e media. Il programma usa conteggio e somma e stampa 4 libri, 1150 pagine. È un caso pratico del problema “voglio più riepiloghi ma non posso riusare lo stesso stream”: le statistiche sono un oggetto risultato che contiene più misure ottenute dal consumo della pipeline. Se un capitolo ha zero libri, alcune statistiche come la media non hanno il significato che avrebbero su una popolazione non vuota; il chiamante deve decidere come rappresentare quell'assenza.
La quarta domanda è “qual è il libro disponibile con meno pagine?”. Dopo il filtro, min(Comparator.comparingInt(Libro::pagine)) confronta i libri secondo il campo pagine e restituisce un Optional<Libro>. map(Libro::titolo) trasforma il libro trovato nel titolo; orElse("nessuno") copre il caso di catalogo senza libri disponibili. Il risultato del programma è Algebra. La forma completa mostra perché Optional del capitolo precedente è stato introdotto: un minimo potrebbe mancare e il chiamante deve esprimere che cosa fare.
reduce serve quando possiamo combinare due valori dello stesso problema in un risultato del medesimo tipo. Con reduce(0, Integer::sum) lo zero è l'identità e la somma combina risultati parziali. Se usiamo reduce per concatenare molte stringhe con a + b, creiamo potenzialmente molti oggetti intermedi; Collectors.joining comunica meglio la finalità. collect è invece pensato per accumulare elementi in una struttura risultato con un protocollo di supplier, accumulator e combiner. Le due operazioni non sono sinonimi universali. Un collector ben scelto evita di condividere una ArrayList esterna fra le lambda della pipeline, soprattutto se la pipeline diventa parallela.
Ridurre e raccogliere risultati
Una riduzione combina più elementi in un risultato. count() restituisce quanti elementi attraversano la pipeline; reduce può combinare numeri o altri valori con un'operazione compatibile; collect usa un collector per costruire un risultato, per esempio una mappa di gruppi. Nel programma, Collectors.groupingBy(String::length) raggruppa parole per lunghezza. Leggendo la chiave 4 otteniamo [Java, Reti]. Non stampiamo l'intera mappa affidandoci al suo ordine, perché il contratto generale di groupingBy non promette un ordine d'iterazione specifico della mappa restituita.
Collectors.teeing applica due collector agli stessi elementi e combina i risultati. L'esempio conta sette numeri e ne somma i valori, stampando 7 elementi, somma 24. Il nome non implica due thread o due passaggi obbligati sulla sorgente: indica una combinazione di due raccolte logiche. Per una somma semplice useremmo mapToInt(...).sum(), più breve. Il collector doppio è utile quando servono davvero due aggregazioni correlate nello stesso risultato.
Nota bene – Identità e associatività. Per usare
reducecorrettamente, il valore iniziale deve comportarsi da identità dell'operazione e la combinazione deve essere associativa se vogliamo che suddivisioni e riaggregazioni producano lo stesso risultato. Per la somma degli interi, 0 è l'identità:0 + xvalex. Per una sottrazione, cambiare il raggruppamento può cambiare il risultato. Questo limite diventa decisivo quando si considera il parallelismo.
findFirst e findAny restituiscono Optional, che introdurremo nel capitolo 19; qui basta sapere che il risultato può essere assente e va gestito. anyMatch, allMatch e noneMatch rispondono a domande booleane e possono arrestarsi prima della fine. sorted ordina gli elementi della pipeline secondo un comparatore o l'ordine naturale; se abbiamo bisogno di conoscere l'ordine della collezione originale, non possiamo dedurlo soltanto dall'ordine prodotto da sorted.
Una riduzione letta elemento per elemento
Per sommare 1, 2 e 3 possiamo scrivere reduce(0, Integer::sum). Il valore iniziale 0 è l'identità della somma: aggiungerlo non altera il primo elemento. La riduzione combina 0 con 1, ottiene 1; combina 1 con 2, ottiene 3; combina 3 con 3, ottiene 6. Non è una scorciatoia magica che esegue sempre esattamente tre chiamate nell'ordine descritto: questa lettura mostra il caso sequenziale, mentre una pipeline parallela può suddividere il lavoro e ricombinare risultati parziali. La somma è associativa nell'aritmetica matematica, ma con int l'overflow resta possibile; per quantità che possono superare il limite occorre un tipo o un controllo appropriato.
Se vogliamo raccogliere i valori in una lista, la domanda cambia: non cerchiamo un numero unico ma una struttura risultato. toList() esprime direttamente la richiesta di una lista non modificabile; collect permette strategie di raccolta più articolate, come un raggruppamento. Accumulare elementi in una ArrayList esterna con effetti in forEach può sembrare simile su tre numeri, ma introduce uno stato condiviso difficile da controllare se la pipeline cambia. La distinzione fra riduzione a un valore, raccolta in una struttura ed effetto esterno prepara una scelta corretta anche quando la pipeline diventa lunga.
Raccolte più ricche: scegliere la struttura finale
Collectors.toCollection(ArrayList::new) costruisce esplicitamente una lista mutabile del tipo richiesto; Collectors.toCollection(TreeSet::new) produce un insieme ordinato che elimina duplicati secondo il suo comparatore. Non è una conversione neutra: due testi che il comparatore considera equivalenti possono diventare un solo elemento, anche se erano due elementi nella sorgente. Se occorre preservare duplicati, un TreeSet non rappresenta il risultato giusto. Collectors.toMap richiede una scelta quando due elementi producono la stessa chiave: senza una funzione di fusione, la collisione è un errore, non una decisione nascosta della libreria.
Supponiamo di voler associare il codice di ciascun libro al suo titolo. Se il catalogo può contenere due edizioni con lo stesso codice, dobbiamo stabilire se la chiave è davvero unica, se va conservata la prima, l'ultima o una lista di entrambe. groupingBy(Libro::codice) esprime una mappa da codice a lista; toMap(Libro::codice, Libro::titolo, (primo, secondo) -> primo) dichiara la politica “tieni il primo”. Quest'ultima è una decisione di dominio che non andrebbe nascosta in una lambda priva di spiegazione. La struttura finale racconta come intendiamo trattare le collisioni.
partitioningBy(predicato) crea due gruppi indicizzati da true e false, adatto a una divisione binaria come disponibili e non disponibili. groupingBy può invece produrre molti gruppi, uno per reparto. mapping come collector a valle permette di raccogliere soltanto i titoli dentro ciascun gruppo; summingInt e averagingDouble calcolano valori per gruppo senza conservare ogni elemento. Non serve memorizzare un elenco di combinazioni: formuliamo la domanda, scegliamo la chiave o il predicato e poi decidiamo che cosa vogliamo dentro ogni gruppo.
Box – Sommare importi monetari. Gli esempi numerici del capitolo usano pagine e conteggi, per cui
intolongsono naturali entro limiti dichiarati. Per denaro,doublepuò introdurre approssimazioni binarie indesiderate. Se il dominio richiede importi decimali esatti e regole di arrotondamento, rappresentiamo gli importi con un tipo adatto comeBigDecimale riduciamoli con una somma coerente con il contratto. Lo stream non decide il modello numerico al posto nostro.
Dal valore numerico allo stream primitivo
IntStream, LongStream e DoubleStream lavorano con valori primitivi; la differenza rispetto a Stream<Integer> si capisce meglio osservando un calcolo. Il programma DemoStreamNumerici.java parte dagli interi da 1 a 4. IntStream.rangeClosed(1, 4) include entrambi gli estremi e produce quattro valori; range(1, 4) si fermerebbe prima di 4. La prima terminale sum() stampa 10. Per fare un secondo calcolo si crea un nuovo stream con una seconda chiamata a rangeClosed: non si riusa quello già consumato. average() calcola la media, cioè la somma 10 divisa per i quattro elementi, e produce un OptionalDouble, perché una sequenza vuota non avrebbe una media. In questo caso sappiamo che non è vuota e orElseThrow() restituisce 2.5.
Nella figura 18.3 le quattro famiglie condividono il contratto BaseStream, ma non lo stesso tipo di elemento. Le tre specializzazioni primitive non sono sottoclassi di Stream<T>: la conversione da oggetti a primitivi e viceversa avviene con metodi come mapToInt e boxed.

Stream<T> elabora oggetti; IntStream, LongStream e DoubleStream elaborano i tre primitivi supportati dalle API specializzate.La terza pipeline applica map(numero -> numero * numero) e ottiene i quadrati 1, 4, 9 e 16. boxed() trasforma i valori primitivi dello IntStream in Integer, così toList() produce una List<Integer> stampata come [1, 4, 9, 16]. Nella quarta pipeline il percorso va nella direzione opposta: Stream.of("2", "3") contiene stringhe, mapToInt(Integer::parseInt) le interpreta come interi e sum() restituisce 5. Se una stringa non rappresenta un intero valido, parseInt lancia un'eccezione; lo stream non la converte automaticamente in zero né la scarta. È il chiamante a decidere se validare prima o gestire l'errore.
Gli stream primitivi evitano il boxing per ogni elemento del percorso numerico e offrono terminali come sum, average, min e max. Non sono un obbligo di stile: se lavoriamo con oggetti del dominio, trasformarli subito in numeri può far perdere il significato delle operazioni. Anche il possibile vantaggio di prestazioni dipende dal lavoro reale. Il primo criterio resta rendere chiaro ciò che entra, ciò che esce e la ragione per cui il tipo cambia.
Scegliere lo stream primitivo quando cambia il problema
L'esempio precedente ha mostrato IntStream su numeri già disponibili. Nel catalogo, invece, partiamo da oggetti Libro e li conserviamo come tali finché la domanda riguarda titolo e disponibilità. mapToInt(Libro::pagine) rende numerico il percorso quando chiediamo una statistica sulle pagine. Per costruire direttamente uno stream primitivo possiamo usare IntStream.of(1, 2, 3), che parte da valori espliciti, oppure IntStream.range(1, 4), che produce 1, 2, 3; rangeClosed(1, 4) include anche 4. Arrays.stream(int[]) produce ancora IntStream. Metodi analoghi esistono per long e double; la libreria non offre uno stream distinto per ogni primitivo Java.
sum() restituisce la somma; average() produce OptionalDouble; min() e max() producono OptionalInt per IntStream. Il carattere opzionale ricorda che una sequenza vuota non ha media, minimo o massimo. Chiamare getAsInt() senza verificare la presenza su uno stream vuoto causa un errore; orElse, orElseThrow o isPresent rendono visibile la scelta. count() restituisce un long, anche per gli stream primitivi. Se i valori possono superare la capacità di int, non basta che il numero di elementi sia long: anche la somma deve usare un tipo o una strategia adatta. mapToLong(...).sum() può essere una scelta, ma un overflow di long resta comunque possibile per dati estremi.
boxed() converte IntStream in Stream<Integer> quando abbiamo bisogno di una collezione di wrapper o di un'API per oggetti. mapToInt percorre la direzione opposta da Stream<T> verso un valore numerico estratto o calcolato. I due passaggi hanno un costo e un significato: se facciamo mapToInt(...).boxed() immediatamente senza ragione, probabilmente stiamo complicando il percorso. Nel programma, mapToInt(Libro::pagine) è motivato da statistiche sulle pagine, mentre i libri restano oggetti fino al punto in cui il numero è necessario.
Gatherer: una trasformazione con memoria
Alcune trasformazioni hanno bisogno di ricordare elementi precedenti. Gatherer è un'astrazione per operazioni intermedie più ricche; la classe Gatherers offre implementazioni pronte. Le API sono stabili da Java 24 e presenti in Java 25, come indica la documentazione ufficiale di Gatherers. Non richiedono opzioni preview nel nostro programma.
Nel programma, dati.stream().gather(Gatherers.windowFixed(3)).toList() produce [[1, 2, 3], [4, 5, 6], [3]]. Ogni finestra raccoglie fino a tre elementi consecutivi; l'ultima può essere più corta. È un caso in cui una semplice map non basta, perché il risultato dipende dal raggruppamento di più input. windowSliding produce finestre sovrapposte; scan emette accumuli progressivi; fold costruisce un accumulo finale secondo il proprio contratto. mapConcurrent usa concorrenza controllata per trasformazioni adatte a quel modello, ma va affrontato insieme ai costi, agli effetti e alle regole del capitolo sulla concorrenza. Per imparare gli stream non occorre partire da un Gatherer personalizzato: prima si dominano sorgente, trasformazioni comuni e terminale.
Immagina che le tre misure di una finestra rappresentino i dati di un giorno. Con windowFixed(3) ogni misura appartiene a un solo gruppo, salvo la finestra finale incompleta. Se invece vogliamo osservare una media mobile, la misura di oggi deve comparire anche accanto a quelle dei giorni vicini: serve una finestra scorrevole e dobbiamo decidere che cosa fare quando mancano ancora abbastanza osservazioni. Prima di cambiare metodo, scriviamo i gruppi attesi per una sequenza piccola e confrontiamoli con l'output. Il criterio per riusare Gatherer è che la trasformazione dipenda da stato o da più elementi del flusso; per convertire ogni titolo in maiuscolo resta sufficiente map. Una soluzione più potente, applicata a un problema che non la richiede, rende soltanto più difficile prevedere il risultato.
Ordine d'incontro: la prima garanzia da dichiarare
Uno stream può avere un ordine d'incontro determinato dalla sorgente, come l'ordine di una List. Altre sorgenti non ne promettono uno. Alcune terminali e alcuni collector preservano un ordine, altri possono non farlo, specialmente in parallelo. forEach su uno stream parallelo non è lo strumento per richiedere una stampa ordinata; forEachOrdered mantiene l'ordine d'incontro quando esiste, ma questa garanzia può ridurre le possibilità di elaborazione parallela.
L'ordine d'incontro è una proprietà della sorgente che influenza la risposta a findFirst e la stampa con forEachOrdered. Non compare automaticamente perché abbiamo scritto una pipeline. Quando introdurremo il parallelismo, questa distinzione resterà decisiva: imporre un ordine può limitare il lavoro simultaneo. La responsabilità di chiudere una risorsa, invece, dipende dalla sorgente e verrà applicata alla pipeline su file alla fine del capitolo.
Parallelismo, ordine e risorse nel programma reale
Il modello degli stream permette di richiedere esecuzione parallela con parallelStream() o parallel(), ma non rende ogni pipeline più veloce. La libreria può dividere la sorgente in porzioni, lavorarle su più thread e combinare i risultati. Questo lavoro ha costi. Un filter molto breve su poche stringhe può andare peggio; un calcolo pesante su una sorgente grande e facilmente divisibile può beneficiare della macchina multicore. L'ordine richiesto e le operazioni stateful, come sorted, possono ridurre il vantaggio. Non esiste una soglia universale di elementi oltre cui “conviene”: bisogna misurare su dati e hardware rappresentativi.
Il parallelismo non significa che il chiamante ottenga subito il controllo come in una API asincrona. Una terminale come toList() ritorna quando il risultato è pronto, anche se il lavoro interno è stato distribuito. La pipeline deve inoltre rispettare le regole di non interferenza: le lambda non devono modificare la sorgente non concorrente durante l'attraversamento. Devono normalmente essere senza stato variabile fra elementi. Un ArrayList esterna a cui ogni elemento aggiunge un risultato è problematica: in parallelo gli aggiornamenti possono correre l'uno contro l'altro, e anche in sequenziale l'effetto è nascosto rispetto al contratto della terminale. toList() e i collector esprimono la raccolta senza quel rischio.
Una List possiede un ordine d'incontro; una HashSet non promette l'ordine in cui vedremo gli elementi. findFirst ha quindi un significato preciso quando la sorgente è ordinata; su una sorgente non ordinata non possiamo prevedere un primo elemento stabile. findAny comunica esplicitamente che qualunque elemento adatto è sufficiente. forEach su una pipeline parallela non promette che le azioni appaiano nell'ordine d'incontro, mentre forEachOrdered lo preserva quando esiste, pagando il costo di quel vincolo. Se l'ordine della stampa è parte del risultato, una lista ordinata raccolta e poi stampata può essere più semplice da verificare.
Uno stream creato da Files.lines(percorso) usa una risorsa del sistema operativo. Il blocco try (Stream<String> righe = Files.lines(percorso)) { ... } ne garantisce la chiusura anche in caso di eccezione. È un'applicazione diretta del capitolo 12: la pipeline elabora righe, il try-with-resources gestisce il ciclo di vita del file. Stream.toList() non sostituisce quel blocco. Al contrario, lo stream di una lista in memoria non richiede di chiudere un file. Il tipo Stream è lo stesso, ma la sorgente determina la responsabilità sulla risorsa.
Metodo per verificare una pipeline. Scrivi prima la domanda in italiano e il risultato atteso su quattro elementi. Segna il tipo dopo ogni passaggio:
Stream<Libro>, poiStream<String>, poiList<String>oppureIntStreame infine un numero. Controlla l'ordine d'incontro se è rilevante, la presenza di effetti esterni e il caso di sorgente vuota. Cambia un dato e prevedi il nuovo risultato prima di eseguire. Solo dopo valuta se una pipeline parallela ha senso e misurala.
Una pipeline per una domanda reale
Supponiamo che il catalogo contenga schede di libri e che vogliamo i titoli dei volumi disponibili, senza spazi superflui e ordinati per la stampa. La domanda può diventare una pipeline: partire dalle schede, filtrare quelle disponibili, estrarre il titolo con map, pulirlo con String::strip, ordinarlo con sorted e raccoglierlo con toList. Ogni passaggio deve avere un significato distinto. Se la disponibilità può cambiare mentre la pipeline è in corso, occorre anche un contratto sullo snapshot dei dati o sulla sincronizzazione: lo stream non rende coerente una sorgente che altri stanno modificando senza regole.
Se dobbiamo soltanto trovare un libro disponibile, costruire e ordinare tutta la lista sarebbe lavoro inutile. Una ricerca con filter(...).findFirst() su una sorgente ordinata esprime meglio il risultato richiesto e può fermarsi al primo elemento adatto. Se l'ordine non conta, findAny() comunica quella libertà, soprattutto in parallelo. La differenza fra i due metodi è una scelta semantica, non una micro-ottimizzazione da applicare senza chiedersi quale risposta sia corretta.
Anche il ciclo tradizionale può restare la soluzione più leggibile. Se ogni elemento richiede una sequenza di controlli con errori differenti e aggiornamenti di stato, comprimere tutto in cinque lambda può nascondere il percorso che dobbiamo diagnosticare. La Stream API è forte quando le trasformazioni e le aggregazioni sono chiare come operazioni sui dati. Non è un obbligo stilistico imposto dal Java moderno.
Effetti e ordine di osservazione
peek permette di osservare elementi che attraversano una pipeline ed è utile soprattutto per diagnosi limitate. Non lo usiamo per aggiornare uno stato da cui dipende il risultato, perché un'operazione intermedia può non essere invocata come ci aspettiamo in ogni pipeline. forEach è terminale e produce un effetto per gli elementi elaborati, ma in parallelo l'ordine di esecuzione delle azioni non coincide necessariamente con l'ordine d'incontro. Se l'output deve avere un ordine stabile, una raccolta in lista seguita da una stampa ordinata è spesso più semplice da ragionare; forEachOrdered è disponibile quando quel vincolo appartiene davvero alla pipeline.
Una riduzione parallela richiede particolare cura con contenitori mutabili. Scrivere da più lambda nella stessa ArrayList esterna non è un modo corretto di raccogliere risultati: introduce stato condiviso e può perdere dati o produrre comportamenti imprevedibili. Un collector adatto gestisce l'accumulo secondo il proprio contratto. Ma anche un collector che funziona in parallelo non garantisce che la pipeline sarà più rapida. Il criterio resta prima correttezza, poi misurazione.
Concetto chiave – Dichiarare le garanzie. Per ogni pipeline chiediamoci quale sia la sorgente, se l'ordine conta, quali funzioni leggono soltanto i dati, quale terminale produce il risultato e chi chiude eventuali risorse. Queste cinque domande sono più utili di una lista a memoria di tutti i metodi di
Stream.
Una pipeline su file: dalla risorsa al risultato
Immaginiamo un file con una parola per riga e la richiesta di contare quelle che iniziano con J. La parte di calcolo può essere righe.map(String::strip).filter(s -> s.startsWith("J")).count(). Prima, però, dobbiamo aprire il file con charset e percorso adeguati e gestire un possibile errore I/O. Files.lines(percorso) restituisce uno stream collegato a una risorsa; il blocco try-with-resources è quindi parte della soluzione, non un'aggiunta facoltativa per i casi sfortunati. Il conteggio finale è un long; non serve materializzare tutte le righe in una lista.
Il programma completo DemoStreamFile.java prepara i dati in una cartella temporanea, dichiara esplicitamente UTF-8 e tiene l'apertura dello stream dentro contaParoleConJ. try-with-resources chiude la risorsa anche se il filtro o la lettura lanciano un'eccezione. La cartella viene rimossa nel blocco finally: il programma non lascia un file di prova nel progetto. Il caso mancante è gestito nel chiamante, dove si può decidere se informare l'utente, ritentare o interrompere il lavoro.
import java.io.IOException;
import java.nio.charset.StandardCharsets;
import java.nio.file.Files;
import java.nio.file.NoSuchFileException;
import java.nio.file.Path;
import java.util.stream.Stream;

public class DemoStreamFile {
    private static long contaParoleConJ(Path percorso) throws IOException {
        try (Stream<String> righe = Files.lines(percorso, StandardCharsets.UTF_8)) {
            return righe.map(String::strip)
                    .filter(parola -> parola.startsWith("J"))
                    .count();
        }
    }

    public static void main(String[] args) throws IOException {
        Path cartella = Files.createTempDirectory("stream-file-");
        Path parole = cartella.resolve("parole.txt");
        Path vuoto = cartella.resolve("vuoto.txt");
        try {
            Files.writeString(parole, "Java\nReti\n JVM \n", StandardCharsets.UTF_8);
            Files.writeString(vuoto, "", StandardCharsets.UTF_8);
            System.out.println("Parole con J: " + contaParoleConJ(parole));
            System.out.println("File vuoto: " + contaParoleConJ(vuoto));
            try {
                contaParoleConJ(cartella.resolve("assente.txt"));
            } catch (NoSuchFileException errore) {
                System.out.println("File assente: " + errore.getClass().getSimpleName());
            }
        } finally {
            Files.deleteIfExists(parole);
            Files.deleteIfExists(vuoto);
            Files.deleteIfExists(cartella);
        }
    }
}
Compila con javac --release 25 -Xlint:all -d build DemoStreamFile.java ed esegui java -cp build DemoStreamFile. Ottieni Parole con J: 2, File vuoto: 0 e File assente: NoSuchFileException. Il primo risultato segue le tre righe Java, Reti, JVM: strip elimina gli spazi esterni e la seconda parola con J diventa JVM. Il file vuoto non fornisce elementi alla pipeline. Nel terzo caso la risorsa non si apre: NoSuchFileException non è un conteggio pari a zero. La prova trasferisce il filtro già noto a una sorgente I/O e aggiunge responsabilità nuove, cioè charset, apertura, chiusura e gestione dell'assenza. Se leggiamo lo stesso file due volte per due domande, lo apriamo due volte oppure definiamo una strategia di conservazione dei dati; non riusiamo lo stream chiuso.
Per verificare
Compila DemoStream.java con javac --release 25 -Xlint:all -d build DemoStream.java ed eseguilo. Prima, prevedi le sei righe: la lista filtrata, la sorgente ancora integra, le parole appiattite, le finestre, il gruppo di lunghezza 4 e il risultato delle due aggregazioni. Compila anche DemoCatalogoStream.java e prevedi i titoli disponibili, il conteggio del reparto Informatica e la somma delle pagine. Poi cambia la finestra da 3 a 2 e spiega perché l'ultimo gruppo è più corto. Infine prova a conservare uno stream in una variabile e a invocare due volte toList() su di essa: spiega quale regola del ciclo di vita hai violato.